Résultats
Les résultats avec les deux approches et plusieurs modèles
Tous les chiffres et figures de cette page sont recalculés au rendu à partir des prédictions exportées (voir la commande d’export en bas de page). La liste des modèles est déduite des runs présents sur S3 : un nouveau modèle exporté apparaît dans les menus au rendu suivant, sans modifier le site.
La page se lit à deux niveaux :
- Un modèle à la fois — le menu Modèle affiché choisit lequel ; chaque tableau et chaque figure y comparent end-to-end et two-stage pour ce modèle.
- Deux modèles entre eux — la zone Comparaison de deux modèles a ses propres menus, et compare à corpus commun.
Modèles disponibles : gemma4-26b-moe, qwen3-6-35b-moe, qwen3-8-27b.
From image to text : les deux approches en détail
Le projet compare deux architectures pour passer de l’image au code. Toutes deux reçoivent la même image et la même grille ; elles diffèrent par le moment où le texte de l’élève devient explicite.
Approche 1 — Deux étapes (transcription puis codage)
Un premier modèle transcrit l’image en texte brut, fautes comprises. Un second compare cette transcription au texte de référence et attribue un code à chaque item.
- Avantage : la transcription est lisible et vérifiable. En cas d’erreur, on sait laquelle des deux étapes a fauté.
- Risque : toute faute de lecture se propage sans recours. L’étape 2 ne voit plus l’image : elle code une lecture erronée sans le savoir.
Approche 2 — End-to-end (une seule passe)
Un seul modèle multimodal reçoit l’image, le texte de référence et la grille, et produit directement le code de chaque item.
- Avantage : le modèle garde l’image sous les yeux au moment de coder, donc il peut arbitrer un doute de lecture à l’aide du mot attendu.
- Risque : la boîte est noire. Un désaccord avec l’expert ne dit pas si le modèle a mal lu ou mal jugé.
Ce qui les distingue
Séparer la lecture du jugement produit deux effets opposés, et c’est la même décision de conception qui les cause : on gagne la possibilité de diagnostiquer (la transcription est lisible), on perd la possibilité de rattraper (l’étape 2 ne voit plus l’image, donc elle code une lecture erronée sans le savoir). Ce n’est pas une contradiction mais un arbitrage que les chiffres tranchent : la synthèse montre l’end-to-end devant sur les modèles testés.
Un modèle à la fois
Le menu ci-dessous choisit le modèle décrit par toute cette partie : chaque tableau et chaque figure y confrontent l’end-to-end et le two-stage de ce seul modèle. Le choix est mémorisé et se retrouve dans l’URL (?modele=…), pour qu’un lien pointe directement sur un modèle.
gemma4-26b-moe
- end-to-end — modèle
gemma4-26b-moe— 3 422 copies × 83 items (dictee_end2end_gemma4-26b-moe) - two-stage — modèle
gemma4-26b-moe— 3 422 copies × 83 items (dictee_two_stage_gemma4-26b-moe)
qwen3-6-35b-moe
- end-to-end — modèle
qwen3-6-35b-moe— 3 422 copies × 83 items (dictee_end2end_qwen3-6-35b-moe) - two-stage — modèle
qwen3-6-35b-moe— 3 422 copies × 83 items (dictee_two_stage_qwen3-6-35b-moe)
qwen3-8-27b
- end-to-end — modèle
qwen3-8-27b— 3 422 copies × 83 items (dictee_end2end_qwen3-8-27b)
Approche(s) non exportée(s) pour ce modèle : two-stage. La comparaison end-to-end vs two-stage est donc incomplète ici.
Synthèse — codage de la dictée
Une colonne par approche, pour le modèle choisi ci-dessus. Le nom de chaque métrique renvoie à sa définition et à sa formule sur la page Évaluation & métriques, qui donne aussi le sens de lecture (faut-il viser haut ou bas ?).
Les intervalles de confiance à 95 % entre crochets sont corrigés de la structure en grappes des données : les observations ne sont pas 290 000 items isolés mais 83 items × 3 469 copies, et les items d’une même copie se ressemblent puisqu’ils ont été écrits par le même élève. Sans cette correction, ils seraient deux à trois fois trop étroits — voir intervalles de confiance et structure en grappes.
| Métrique | end-to-end | two-stage |
|---|---|---|
| Accord brut | 82.9 % [82.7 % ; 83.2 %] | 70.6 % [70.0 % ; 71.1 %] |
| Kappa de Cohen | 0.496 [0.489 ; 0.503] | 0.367 [0.360 ; 0.375] |
| Rappel des erreurs (sensibilité) | 58.1 % [57.4 % ; 58.9 %] | 75.1 % [74.5 % ; 75.7 %] |
| Précision sur les erreurs | 63.9 % [63.1 % ; 64.6 %] | 44.4 % [43.8 % ; 45.1 %] |
| Taux de sur-correction | 41.9 % [41.1 % ; 42.6 %] | 24.9 % [24.3 % ; 25.5 %] |
| Taux de sur-détection | 9.1 % [8.9 % ; 9.4 %] | 26.0 % [25.5 % ; 26.6 %] |
| ECE (calibration) | 0.167 | 0.246 |
| Copies écartées du corpus | 0 (0.00 %) | 0 (0.00 %) |
| Métrique | end-to-end | two-stage |
|---|---|---|
| Accord brut | 87.0 % [86.7 % ; 87.3 %] | 79.7 % [79.2 % ; 80.2 %] |
| Kappa de Cohen | 0.564 [0.557 ; 0.572] | 0.452 [0.444 ; 0.460] |
| Rappel des erreurs (sensibilité) | 52.0 % [51.2 % ; 52.8 %] | 62.1 % [61.3 % ; 62.8 %] |
| Précision sur les erreurs | 84.5 % [83.9 % ; 85.0 %] | 57.4 % [56.7 % ; 58.1 %] |
| Taux de sur-correction | 48.0 % [47.2 % ; 48.8 %] | 37.9 % [37.2 % ; 38.7 %] |
| Taux de sur-détection | 2.6 % [2.5 % ; 2.9 %] | 12.8 % [12.3 % ; 13.3 %] |
| ECE (calibration) | 0.124 | 0.187 |
| Copies écartées du corpus | 0 (0.00 %) | 0 (0.00 %) |
| Métrique | end-to-end |
|---|---|
| Accord brut | 85.4 % [85.1 % ; 85.7 %] |
| Kappa de Cohen | 0.488 [0.479 ; 0.498] |
| Rappel des erreurs (sensibilité) | 42.8 % [42.0 % ; 43.7 %] |
| Précision sur les erreurs | 82.6 % [81.9 % ; 83.3 %] |
| Taux de sur-correction | 57.2 % [56.3 % ; 58.0 %] |
| Taux de sur-détection | 2.5 % [2.3 % ; 2.7 %] |
| ECE (calibration) | 0.136 |
| Copies écartées du corpus | 0 (0.00 %) |
Ce que dit ce tableau.
Les deux approches se trompent différemment. L’end-to-end est plus prudent : il valide beaucoup d’items et rate donc une grande part des erreurs de l’élève (sur-correction élevée). Le two-stage détecte davantage d’erreurs mais en invente aussi beaucoup (précision plus faible, sur-détection élevée). À modèle égal, l’end-to-end garde le meilleur kappa.
Le kappa cache deux profils d’erreur opposés, et c’est ce qui doit guider le choix : sanctionner un élève à tort (sur-détection) et laisser passer une faute (sur-correction) n’ont pas le même coût pour la DEPP. C’est cet arbitrage, et non le kappa seul, qui tranche — le classement des modèles est dans la zone de comparaison.
Dans tous les cas, le kappa reste loin de la variabilité inter-codeurs humains (0,879 sur le test pilote) : à ce stade, aucune configuration n’est utilisable sans relecture humaine.
Les modèles renvoient un score de confiance quasi constant à 1,0 : l’ECE se réduit alors au taux d’erreur et ne mesure plus rien d’utile — un score constant ne discrimine rien, et aucune recalibration n’y changerait quoi que ce soit. C’est précisément pourquoi le projet construit un score de confiance par désaccord inter-modèles, bien plus prédictif (voir la zone de comparaison).
Prévalence d’erreur par item
Objectif DEPP :
- calculer le nombre d’erreurs par copie ;
- calculer le nombre d’erreurs par item.
Chaque point est un item de la dictée ; un point sous la diagonale signifie que le modèle sous-estime la difficulté de cet item.
Les intervalles de confiance sont des intervalles de Wilson sans correction de clustering, et c’est volontaire : pour un item donné, il y a exactement une observation par copie, chacune venant d’un élève différent — voir où la correction ne s’applique pas.
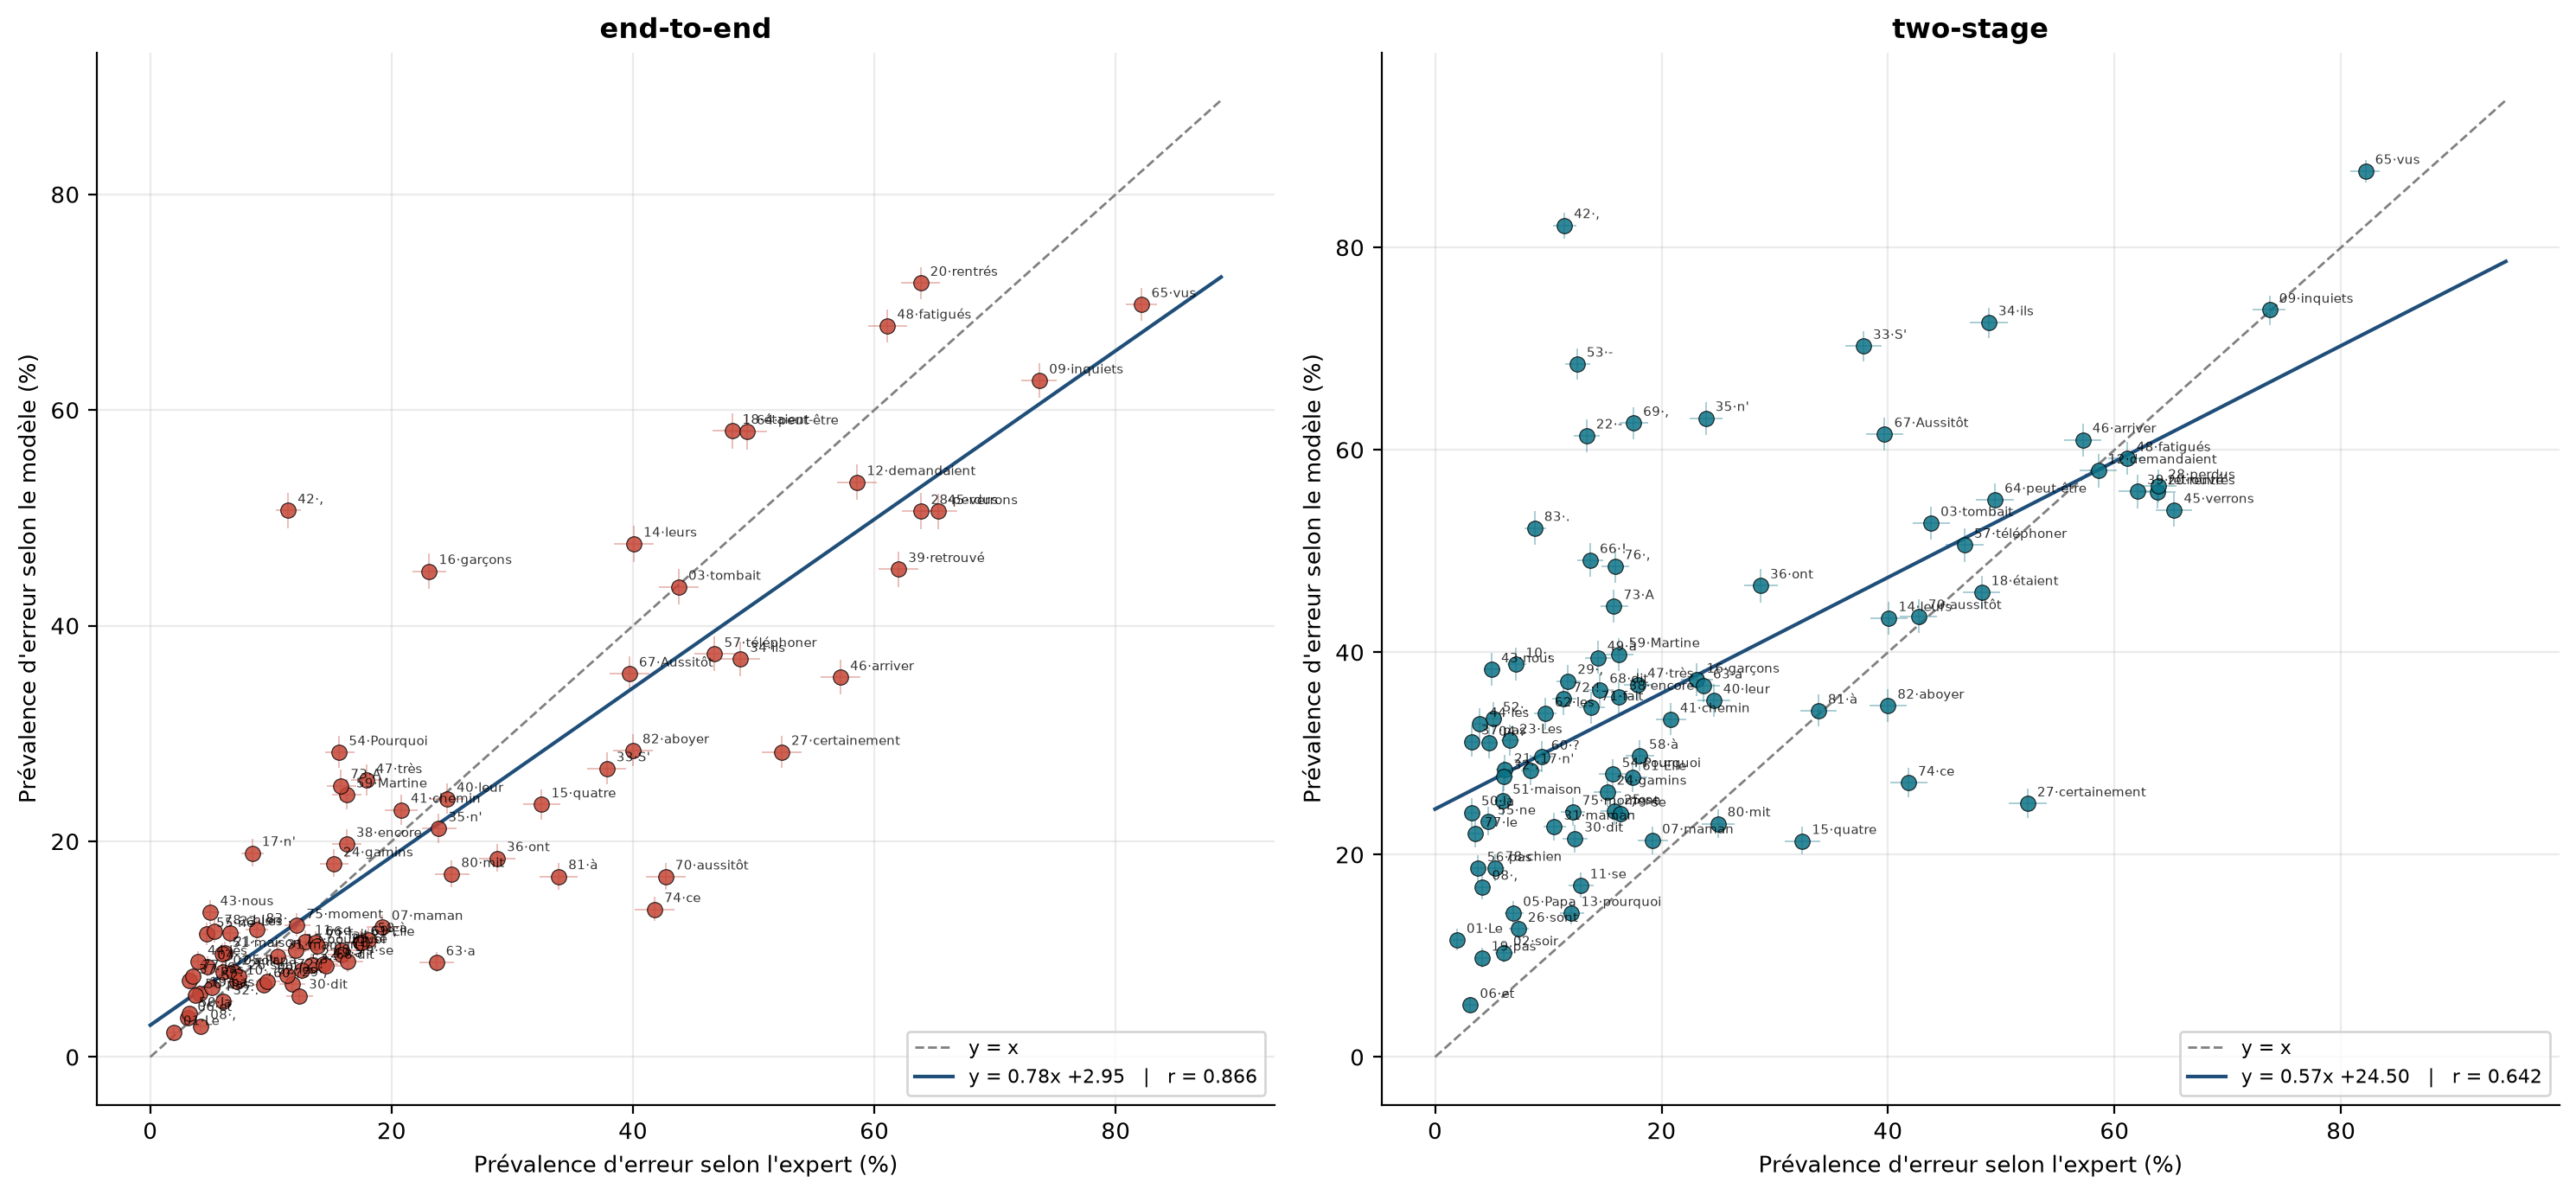
gemma4-26b-moe (axe vertical). Les traits fins sont les intervalles de Wilson à 95 %.| Approche | Pearson r | Spearman ρ | Pente | R² | Biais moyen |
|---|---|---|---|---|---|
| end-to-end | +0.866 | +0.827 | 0.782 | 0.751 | -1.94 pts |
| two-stage | +0.641 | +0.617 | 0.572 | 0.412 | +14.99 pts |
Lecture : un Spearman ρ élevé signifie que le modèle retrouve le bon classement des items difficiles, même si le niveau de prévalence est biaisé (colonne « biais moyen »).
Les items sur lesquels le modèle s’écarte le plus de l’expert :
| Rang | Mot attendu | Erreur — expert | Erreur — modèle | Écart |
|---|---|---|---|---|
| 42 | , |
10.1 % | 50.0 % | +39.9 pts |
| 74 | ce |
41.0 % | 12.6 % | -28.4 pts |
| 70 | aussitôt |
41.8 % | 15.6 % | -26.2 pts |
| 27 | certainement |
51.7 % | 27.4 % | -24.3 pts |
| 16 | garçons |
22.0 % | 44.4 % | +22.4 pts |
| 46 | arriver |
56.5 % | 34.4 % | -22.0 pts |
| 81 | à |
32.9 % | 15.6 % | -17.2 pts |
| 39 | retrouvé |
61.5 % | 44.5 % | -16.9 pts |
| 63 | a |
22.6 % | 7.6 % | -15.0 pts |
| 45 | verrons |
64.7 % | 49.9 % | -14.8 pts |
| 28 | perdus |
63.4 % | 50.0 % | -13.4 pts |
| 54 | Pourquoi |
14.4 % | 27.2 % | +12.9 pts |
| 65 | vus |
81.9 % | 69.5 % | -12.4 pts |
| 34 | ils |
48.2 % | 36.1 % | -12.0 pts |
| 82 | aboyer |
39.1 % | 27.5 % | -11.6 pts |
| Rang | Mot attendu | Erreur — expert | Erreur — modèle | Écart |
|---|---|---|---|---|
| 42 | , |
10.1 % | 82.0 % | +71.8 pts |
| 53 | - |
11.3 % | 68.1 % | +56.8 pts |
| 22 | - |
12.2 % | 60.9 % | +48.7 pts |
| 69 | , |
16.3 % | 62.1 % | +45.8 pts |
| 83 | . |
7.5 % | 51.6 % | +44.1 pts |
| 35 | n' |
22.8 % | 62.6 % | +39.8 pts |
| 66 | ! |
12.4 % | 48.3 % | +35.9 pts |
| 43 | nous |
3.6 % | 37.5 % | +33.8 pts |
| 76 | , |
14.7 % | 47.8 % | +33.1 pts |
| 33 | S' |
37.0 % | 69.8 % | +32.9 pts |
| 10 | , |
5.9 % | 38.0 % | +32.1 pts |
| 44 | les |
2.6 % | 32.0 % | +29.4 pts |
| 73 | A |
14.6 % | 43.8 % | +29.2 pts |
| 52 | . |
3.8 % | 32.5 % | +28.7 pts |
| 37 | pas |
1.8 % | 30.2 % | +28.4 pts |
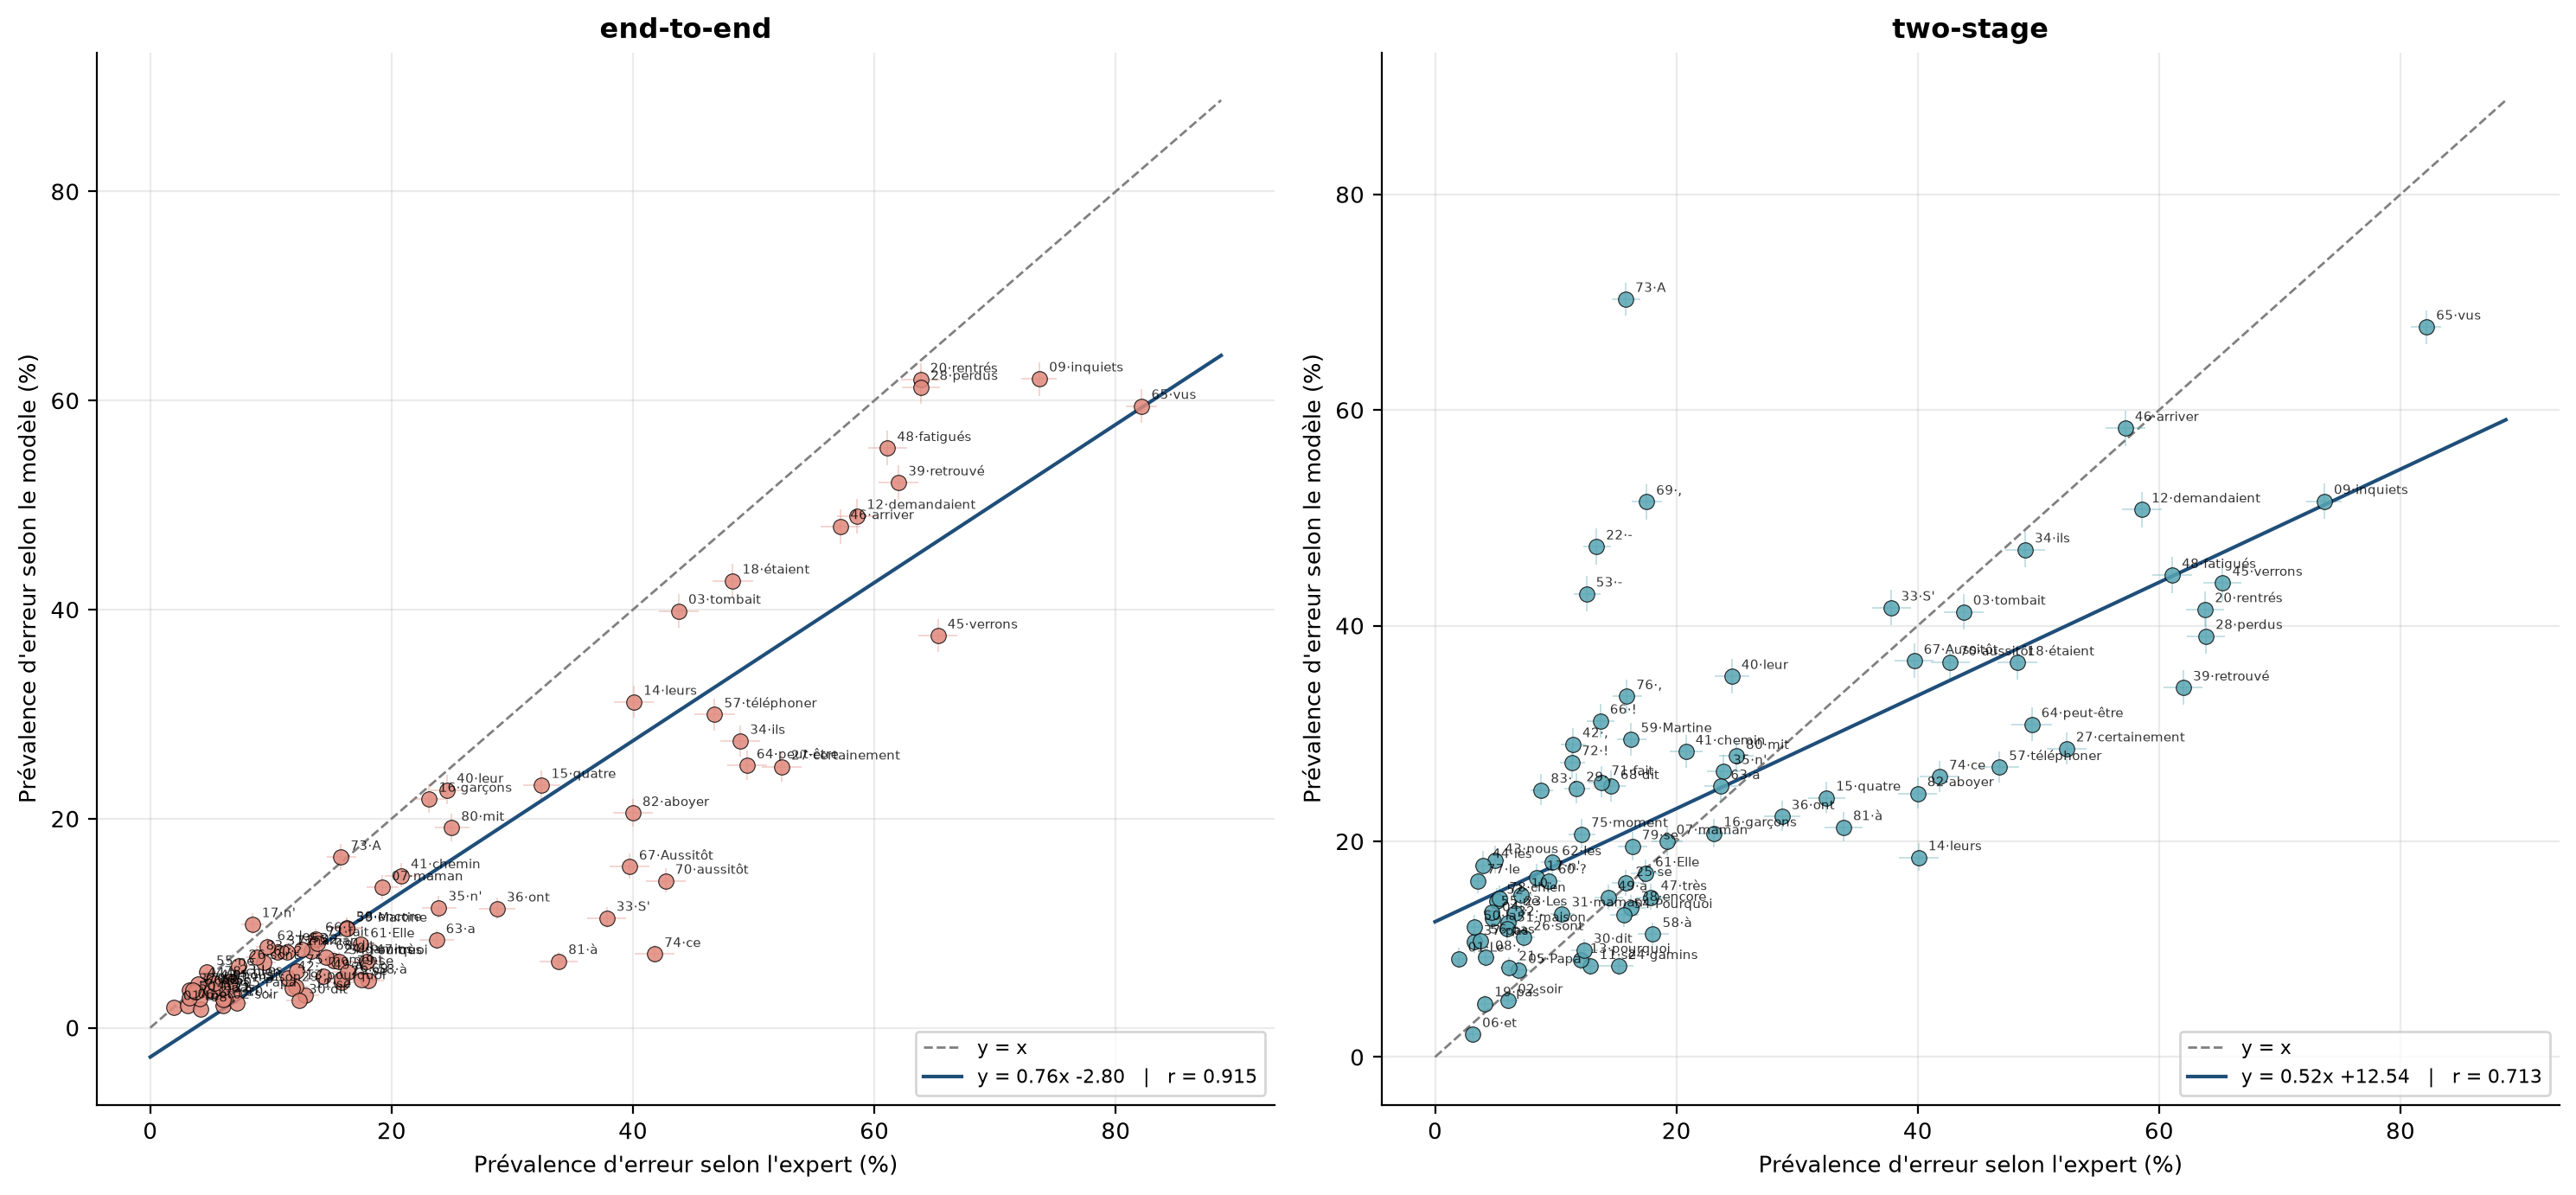
qwen3-6-35b-moe (axe vertical). Les traits fins sont les intervalles de Wilson à 95 %.| Approche | Pearson r | Spearman ρ | Pente | R² | Biais moyen |
|---|---|---|---|---|---|
| end-to-end | +0.915 | +0.879 | 0.757 | 0.837 | -8.35 pts |
| two-stage | +0.713 | +0.746 | 0.524 | 0.509 | +1.76 pts |
Lecture : un Spearman ρ élevé signifie que le modèle retrouve le bon classement des items difficiles, même si le niveau de prévalence est biaisé (colonne « biais moyen »).
Les items sur lesquels le modèle s’écarte le plus de l’expert :
| Rang | Mot attendu | Erreur — expert | Erreur — modèle | Écart |
|---|---|---|---|---|
| 74 | ce |
41.0 % | 5.8 % | -35.1 pts |
| 70 | aussitôt |
41.8 % | 13.0 % | -28.9 pts |
| 45 | verrons |
64.7 % | 36.7 % | -28.0 pts |
| 81 | à |
32.9 % | 5.1 % | -27.7 pts |
| 27 | certainement |
51.7 % | 24.0 % | -27.7 pts |
| 33 | S' |
37.0 % | 9.4 % | -27.6 pts |
| 64 | peut-être |
48.7 % | 24.1 % | -24.6 pts |
| 67 | Aussitôt |
38.8 % | 14.3 % | -24.4 pts |
| 65 | vus |
81.9 % | 59.0 % | -22.9 pts |
| 34 | ils |
48.2 % | 26.5 % | -21.7 pts |
| 82 | aboyer |
39.1 % | 19.5 % | -19.6 pts |
| 36 | ont |
27.7 % | 10.2 % | -17.5 pts |
| 57 | téléphoner |
45.9 % | 29.1 % | -16.8 pts |
| 63 | a |
22.6 % | 7.2 % | -15.4 pts |
| 58 | à |
16.8 % | 3.3 % | -13.6 pts |
| Rang | Mot attendu | Erreur — expert | Erreur — modèle | Écart |
|---|---|---|---|---|
| 73 | A |
14.6 % | 69.9 % | +55.3 pts |
| 69 | , |
16.3 % | 50.8 % | +34.5 pts |
| 22 | - |
12.2 % | 46.6 % | +34.5 pts |
| 53 | - |
11.3 % | 42.2 % | +30.9 pts |
| 39 | retrouvé |
61.5 % | 33.4 % | -28.1 pts |
| 28 | perdus |
63.4 % | 38.2 % | -25.2 pts |
| 27 | certainement |
51.7 % | 27.6 % | -24.0 pts |
| 20 | rentrés |
63.2 % | 40.7 % | -22.6 pts |
| 09 | inquiets |
73.3 % | 50.9 % | -22.4 pts |
| 14 | leurs |
39.3 % | 17.4 % | -21.8 pts |
| 45 | verrons |
64.7 % | 43.2 % | -21.5 pts |
| 57 | téléphoner |
45.9 % | 25.8 % | -20.1 pts |
| 64 | peut-être |
48.7 % | 29.8 % | -18.8 pts |
| 42 | , |
10.1 % | 28.0 % | +17.8 pts |
| 76 | , |
14.7 % | 32.5 % | +17.8 pts |
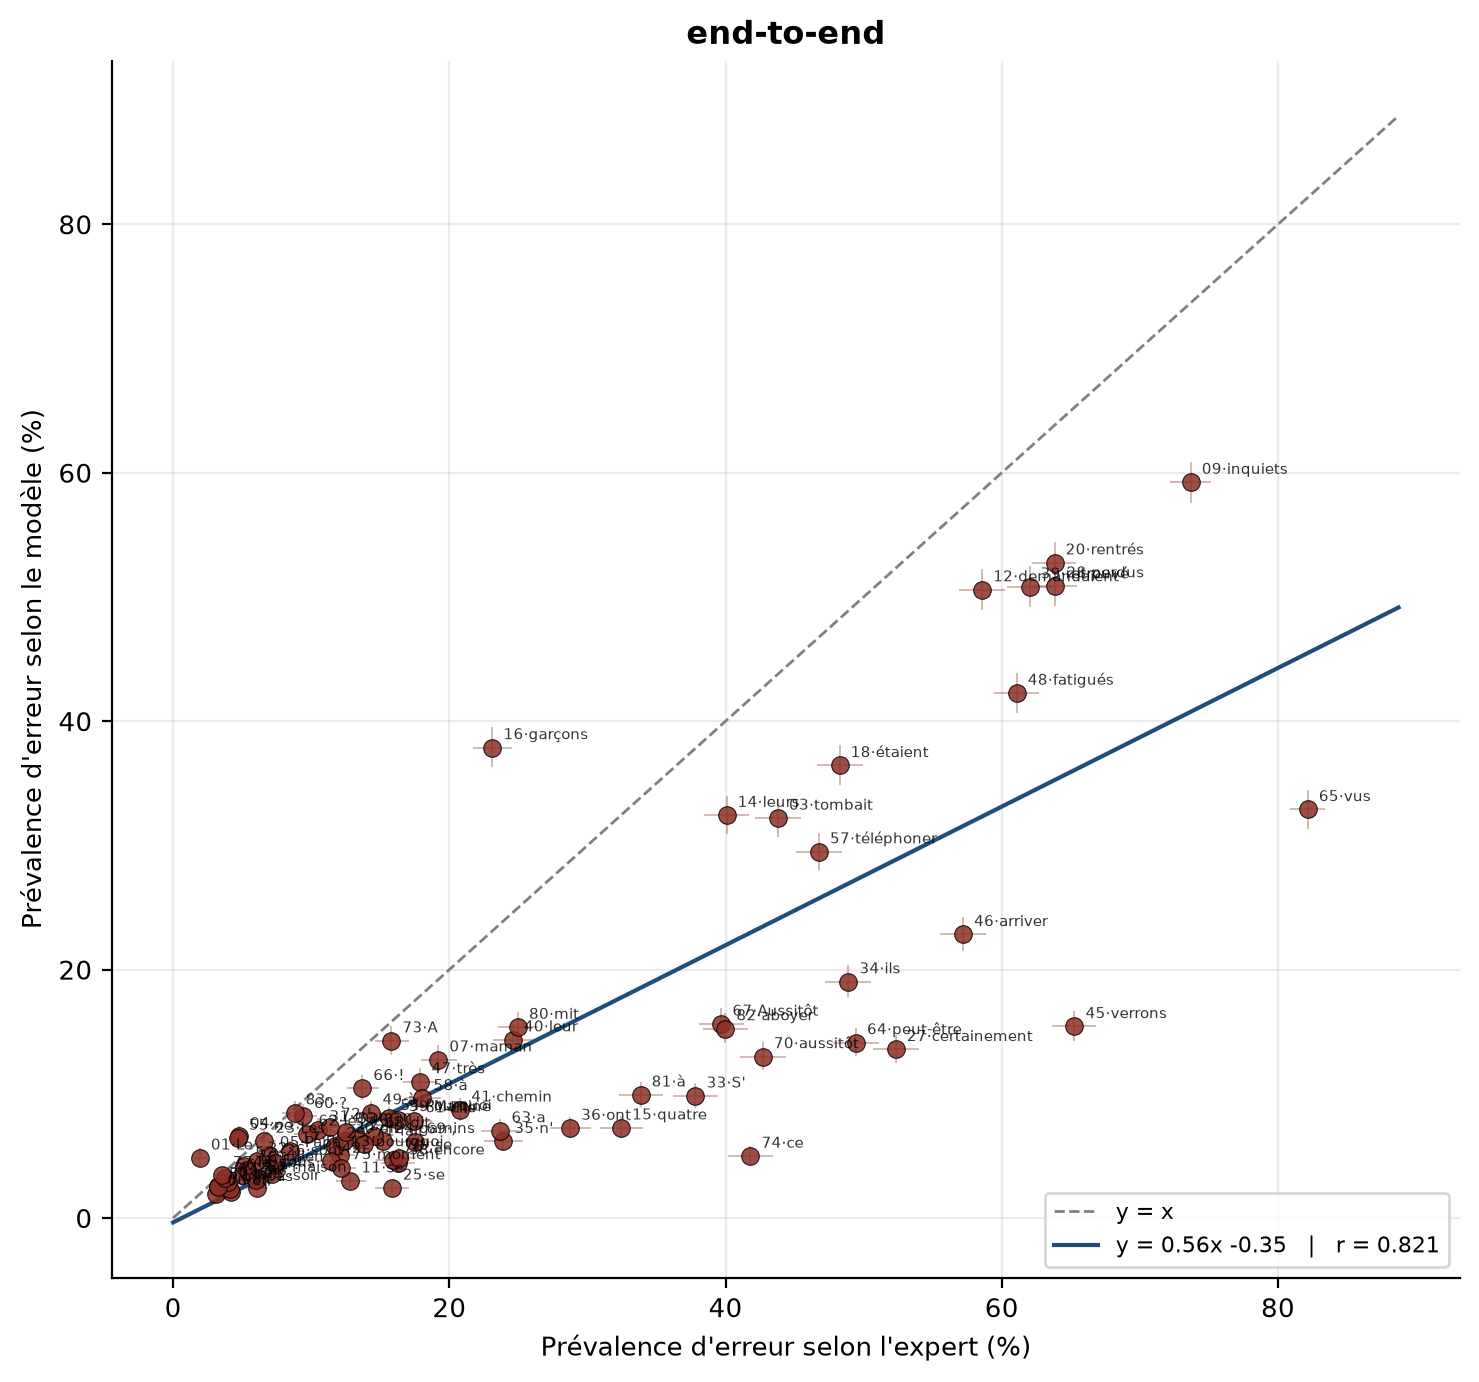
qwen3-8-27b (axe vertical). Les traits fins sont les intervalles de Wilson à 95 %.| Approche | Pearson r | Spearman ρ | Pente | R² | Biais moyen |
|---|---|---|---|---|---|
| end-to-end | +0.821 | +0.836 | 0.558 | 0.674 | -10.45 pts |
Lecture : un Spearman ρ élevé signifie que le modèle retrouve le bon classement des items difficiles, même si le niveau de prévalence est biaisé (colonne « biais moyen »).
Les items sur lesquels le modèle s’écarte le plus de l’expert :
| Rang | Mot attendu | Erreur — expert | Erreur — modèle | Écart |
|---|---|---|---|---|
| 45 | verrons |
64.7 % | 14.3 % | -50.4 pts |
| 65 | vus |
81.9 % | 32.1 % | -49.8 pts |
| 27 | certainement |
51.7 % | 12.5 % | -39.2 pts |
| 74 | ce |
41.0 % | 3.8 % | -37.2 pts |
| 64 | peut-être |
48.7 % | 13.0 % | -35.7 pts |
| 46 | arriver |
56.5 % | 21.9 % | -34.5 pts |
| 34 | ils |
48.2 % | 18.0 % | -30.1 pts |
| 70 | aussitôt |
41.8 % | 11.9 % | -29.9 pts |
| 33 | S' |
37.0 % | 8.7 % | -28.3 pts |
| 15 | quatre |
31.5 % | 6.1 % | -25.4 pts |
| 82 | aboyer |
39.1 % | 14.2 % | -24.9 pts |
| 67 | Aussitôt |
38.8 % | 14.6 % | -24.2 pts |
| 81 | à |
32.9 % | 8.7 % | -24.1 pts |
| 36 | ont |
27.7 % | 6.1 % | -21.7 pts |
| 48 | fatigués |
60.5 % | 41.6 % | -19.0 pts |
Distribution du nombre d’erreurs par copie
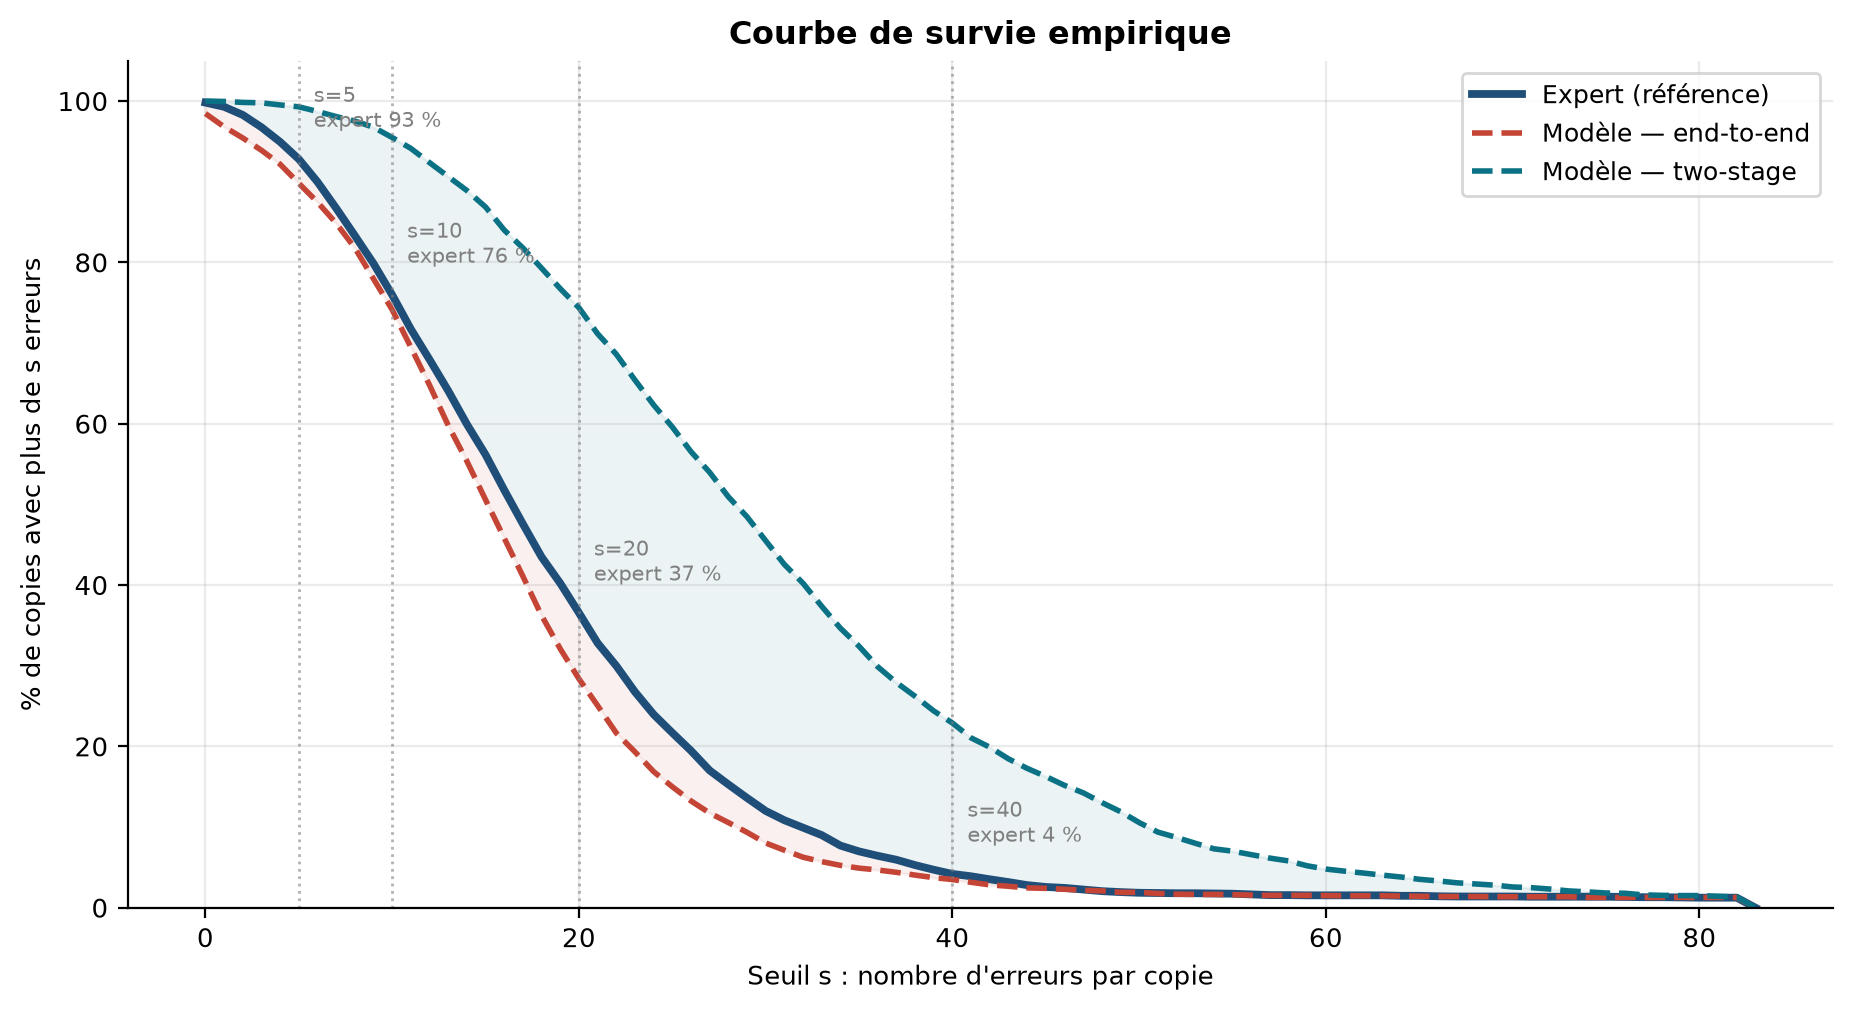
Trois vues par approche : erreurs totales, fautes d’orthographe seules (code 9), et mots absents (code 0). Un décalage des moyennes révèle un biais systématique ; un décalage des formes révèle un biais qui dépend du niveau de l’élève.
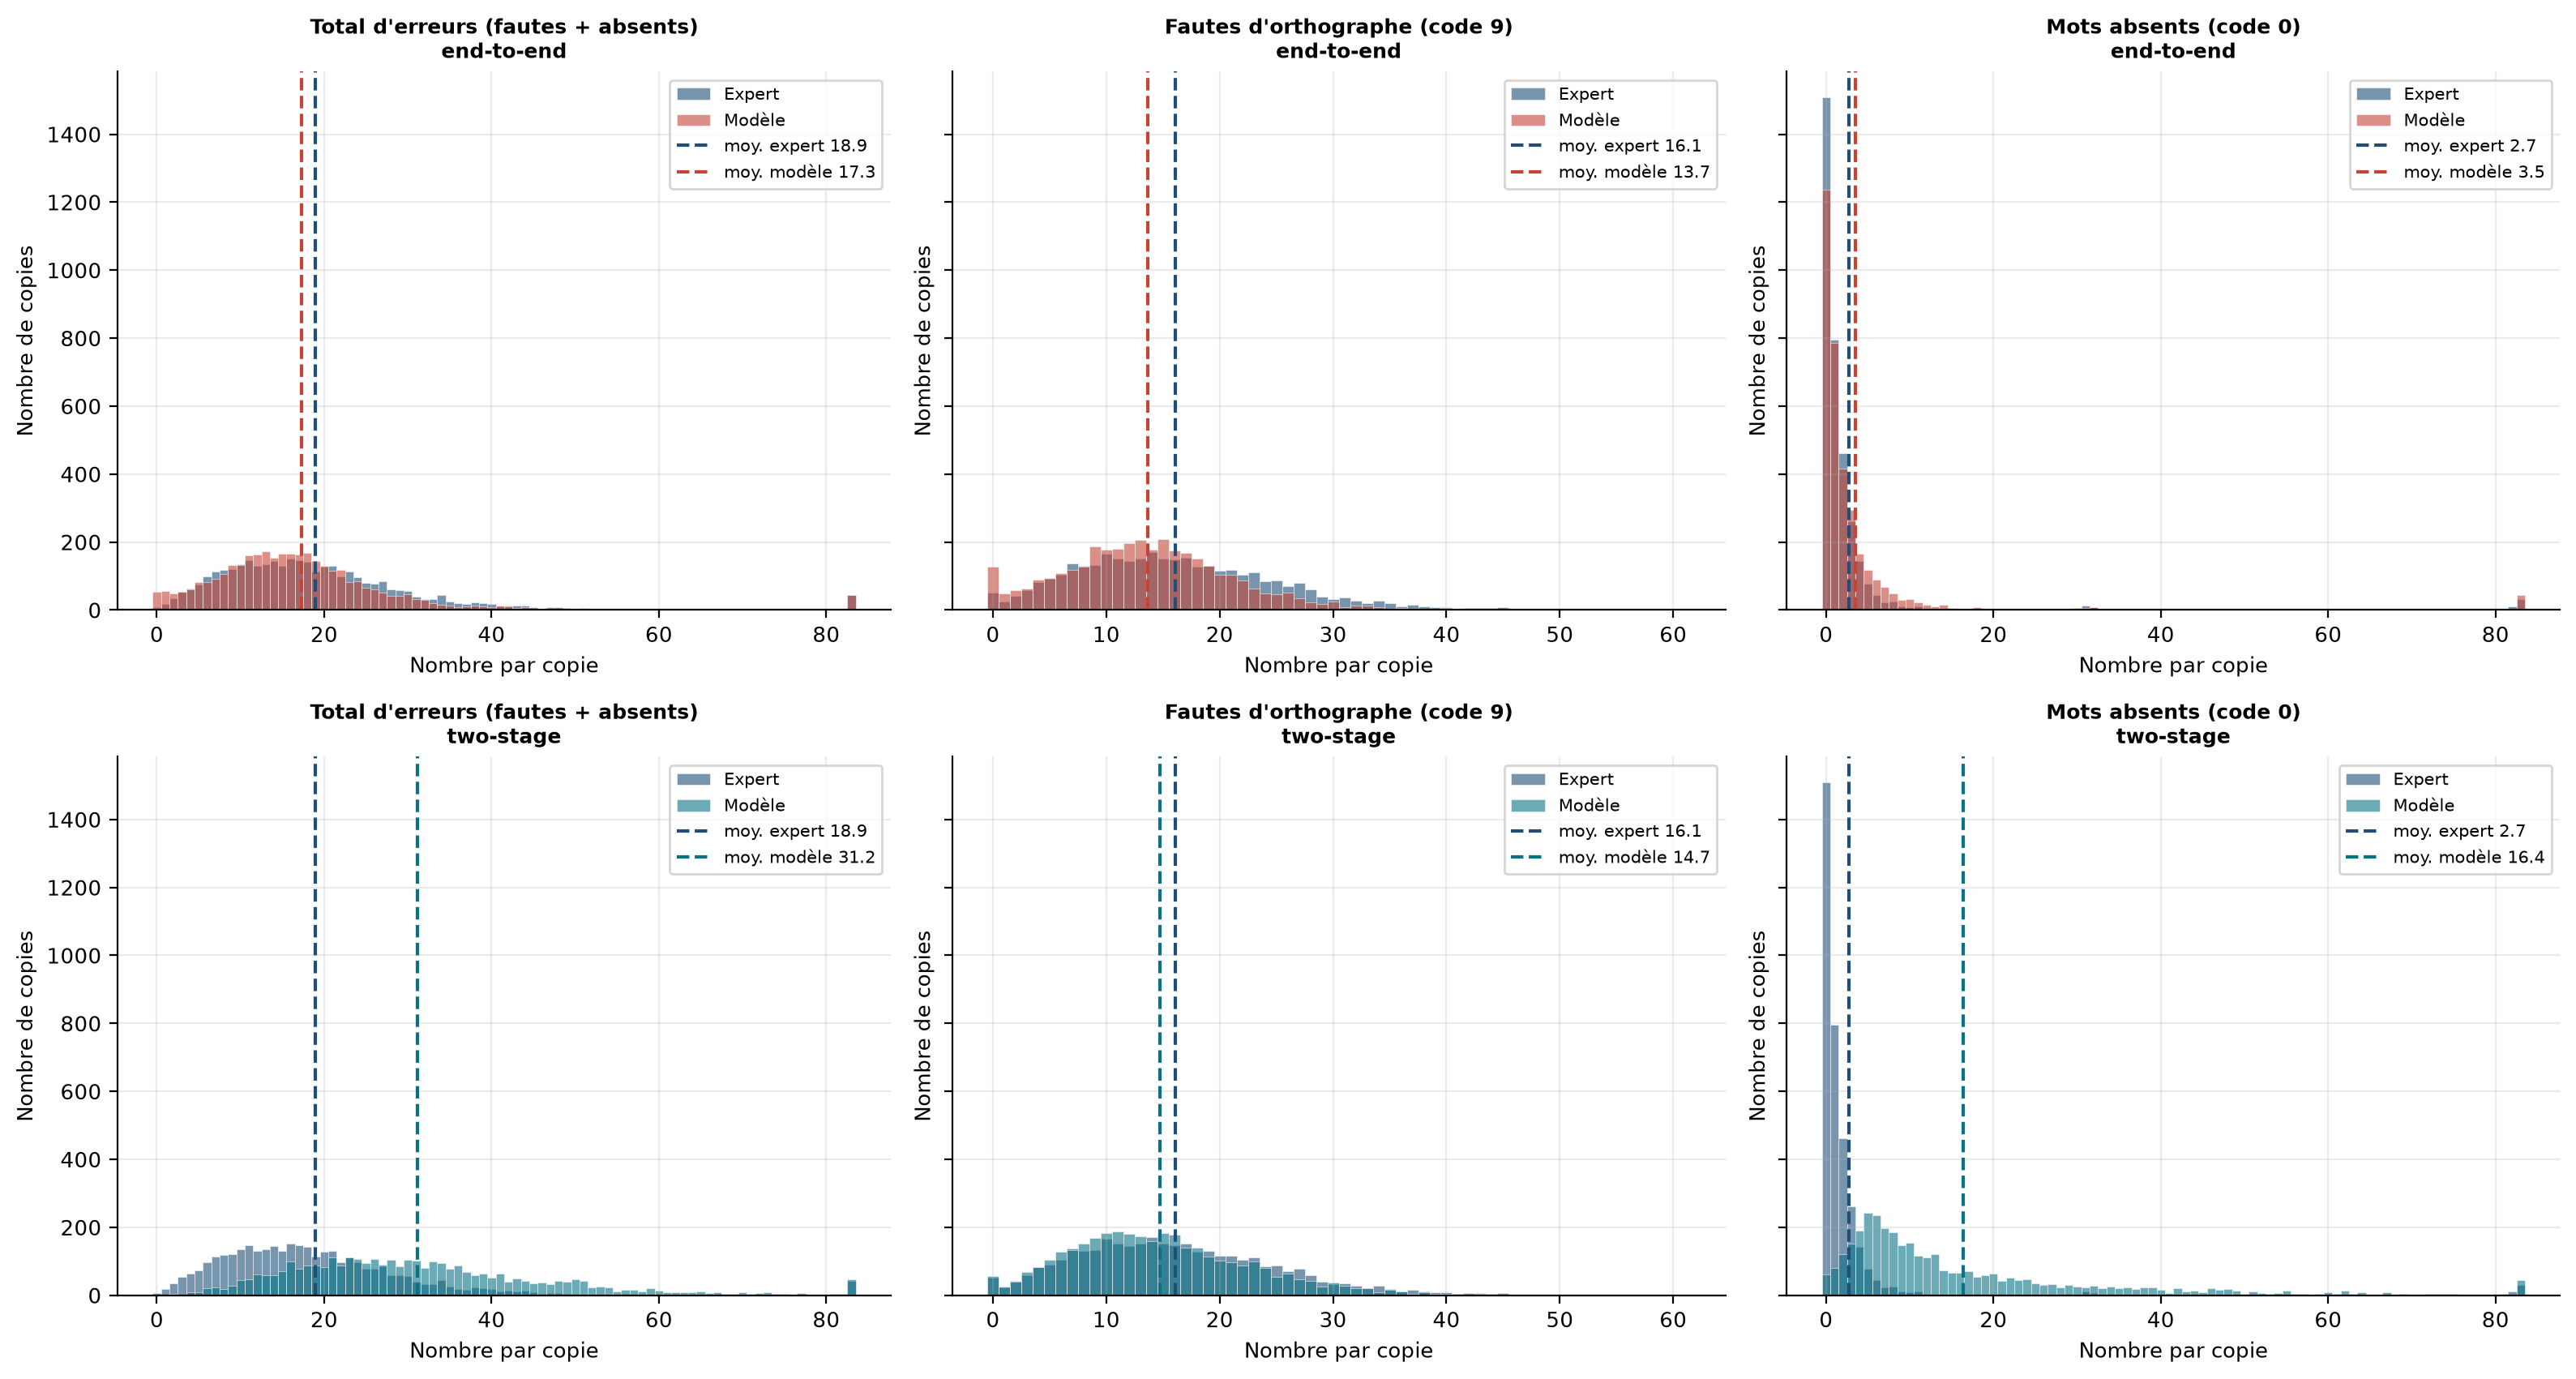
gemma4-26b-moe, pour chaque approche.| Nombre d’erreurs par copie | Moyenne | Médiane | Écart-type | Q1 | Q3 | Max |
|---|---|---|---|---|---|---|
| Expert | 18.01 | 17.0 | 9.96 | 11.0 | 24.0 | 76 |
| Modèle — end-to-end | 16.40 | 15.0 | 9.43 | 10.0 | 21.0 | 74 |
| ↳ test de Kolmogorov–Smirnov (end-to-end) | D = 0.081 | p = 3.6e-10 | ||||
| Modèle — two-stage | 30.44 | 29.0 | 14.19 | 20.0 | 39.0 | 83 |
| ↳ test de Kolmogorov–Smirnov (two-stage) | D = 0.394 | p = 9.9e-238 |
Le test de Kolmogorov–Smirnov compare la distribution du modèle à celle de l’expert : une p-valeur très faible signifie que les deux distributions diffèrent, au-delà de leurs seules moyennes.
La courbe de survie chiffre directement ce qui sert au pilotage : la part de copies au-dessus de chaque seuil d’erreurs.
gemma4-26b-moe.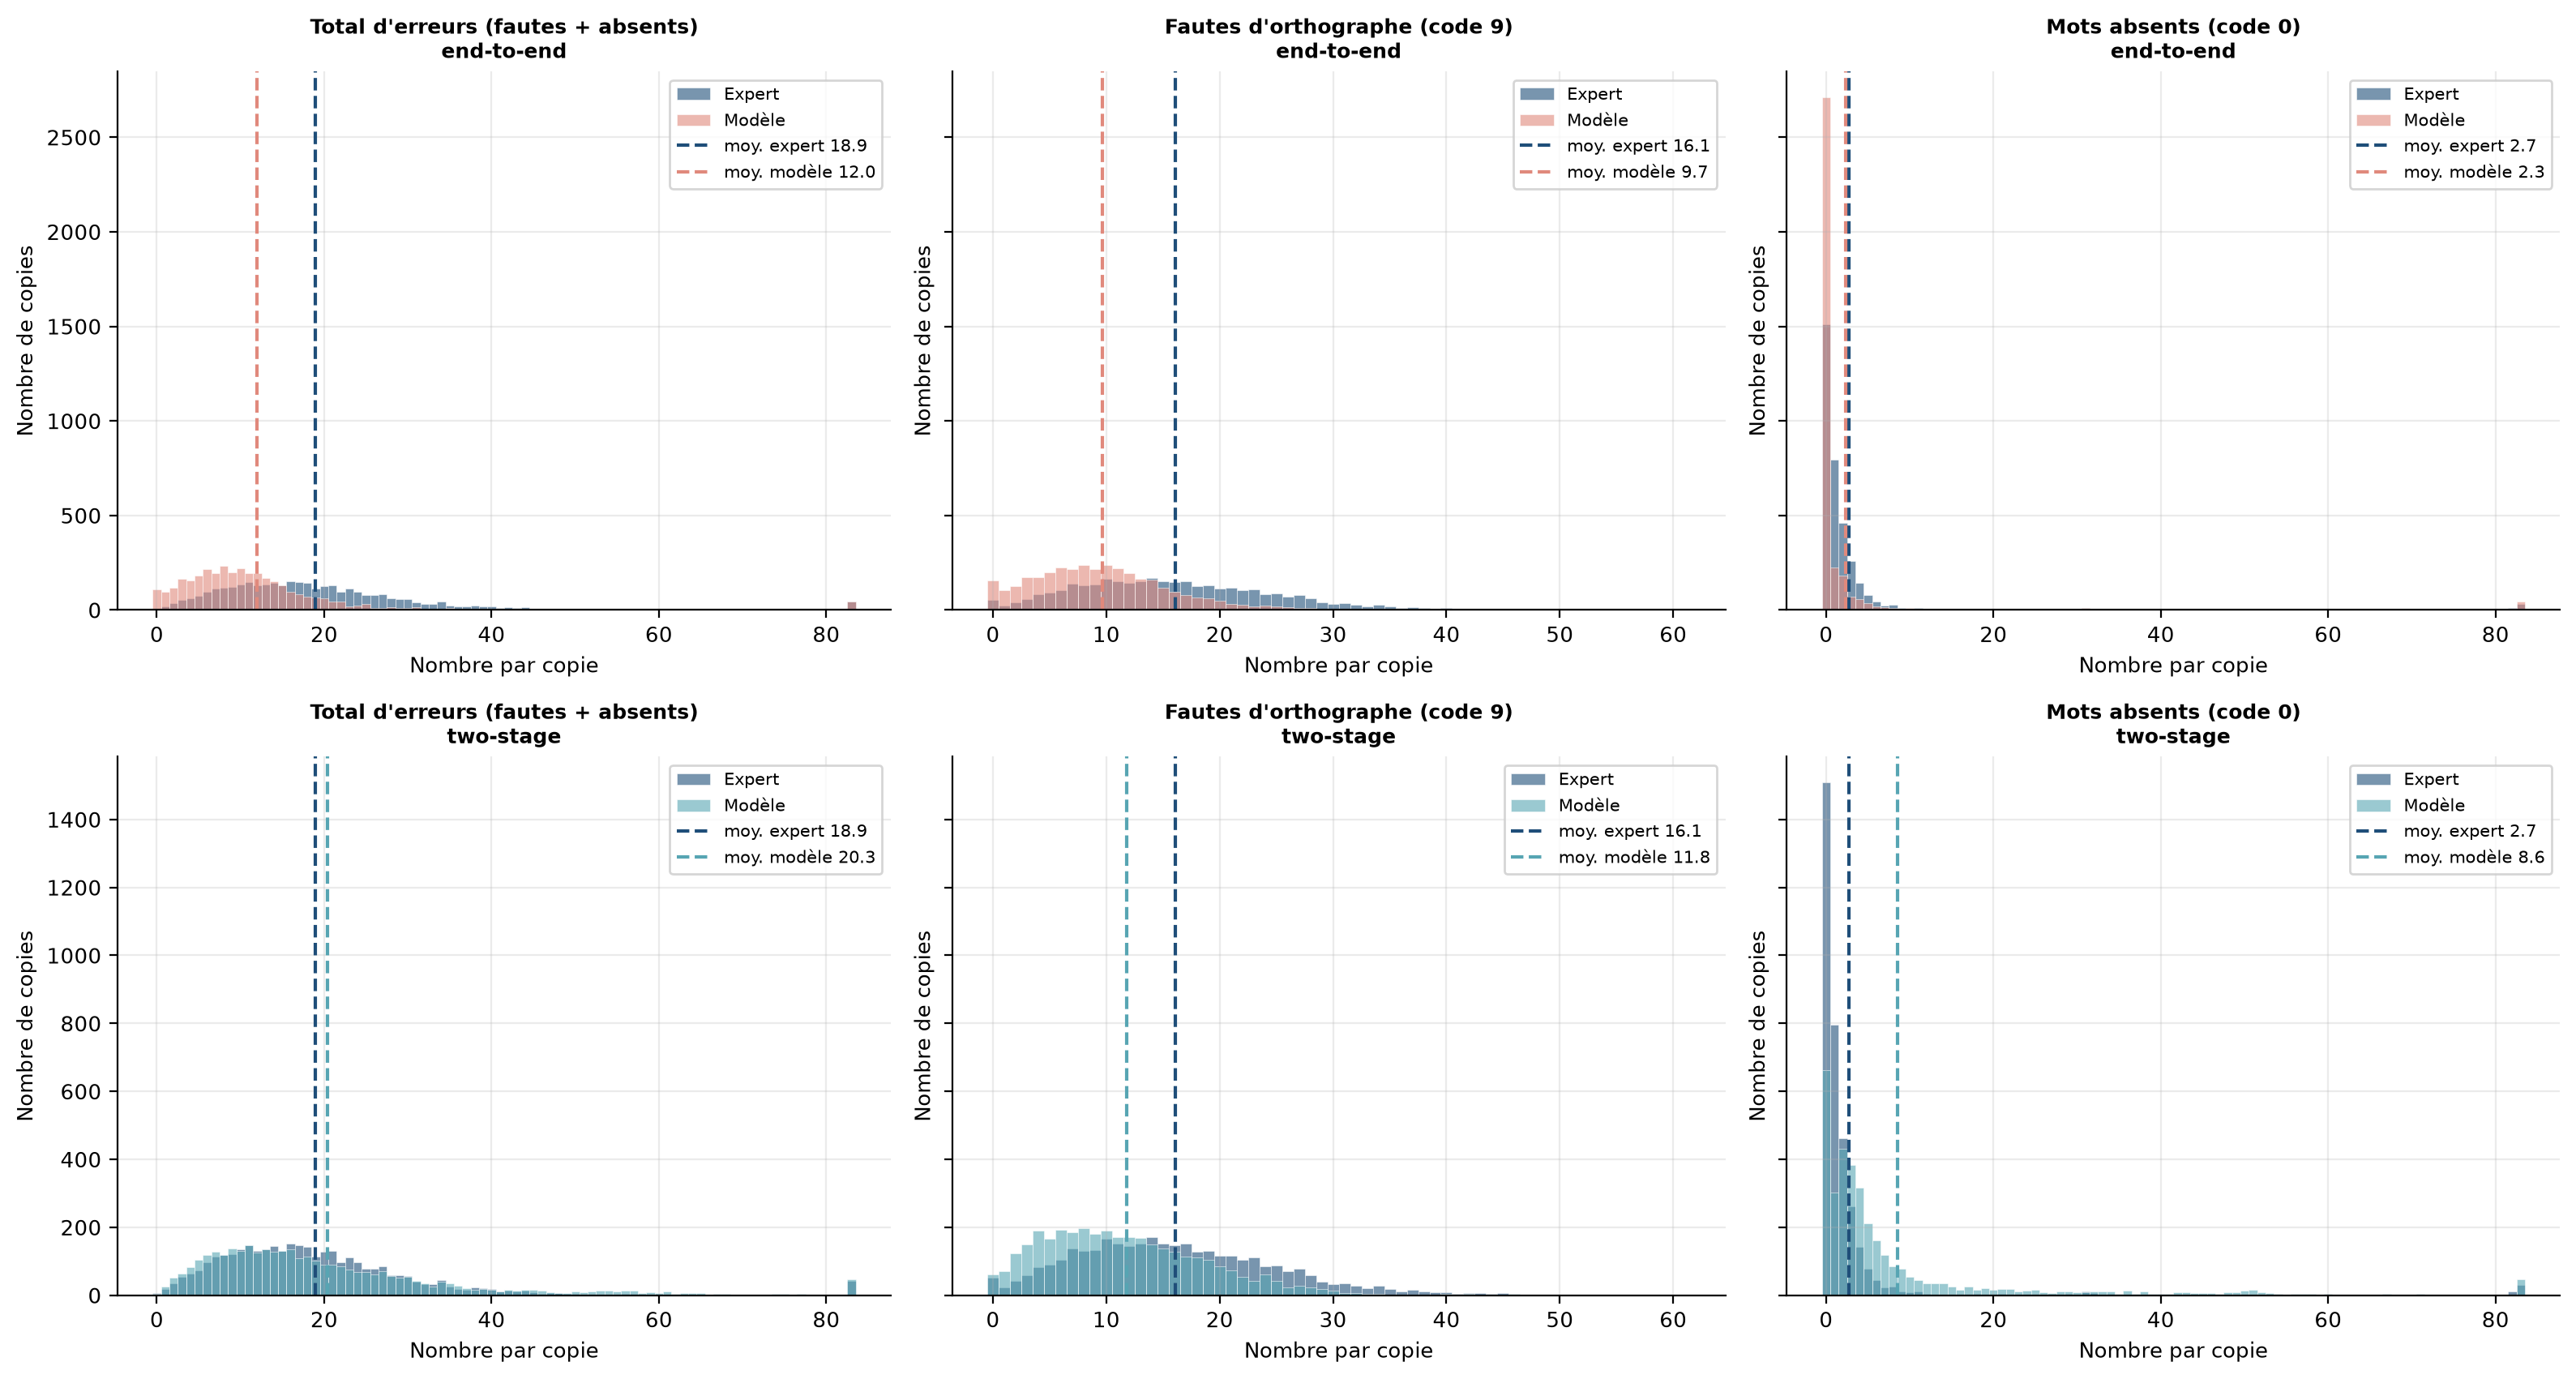
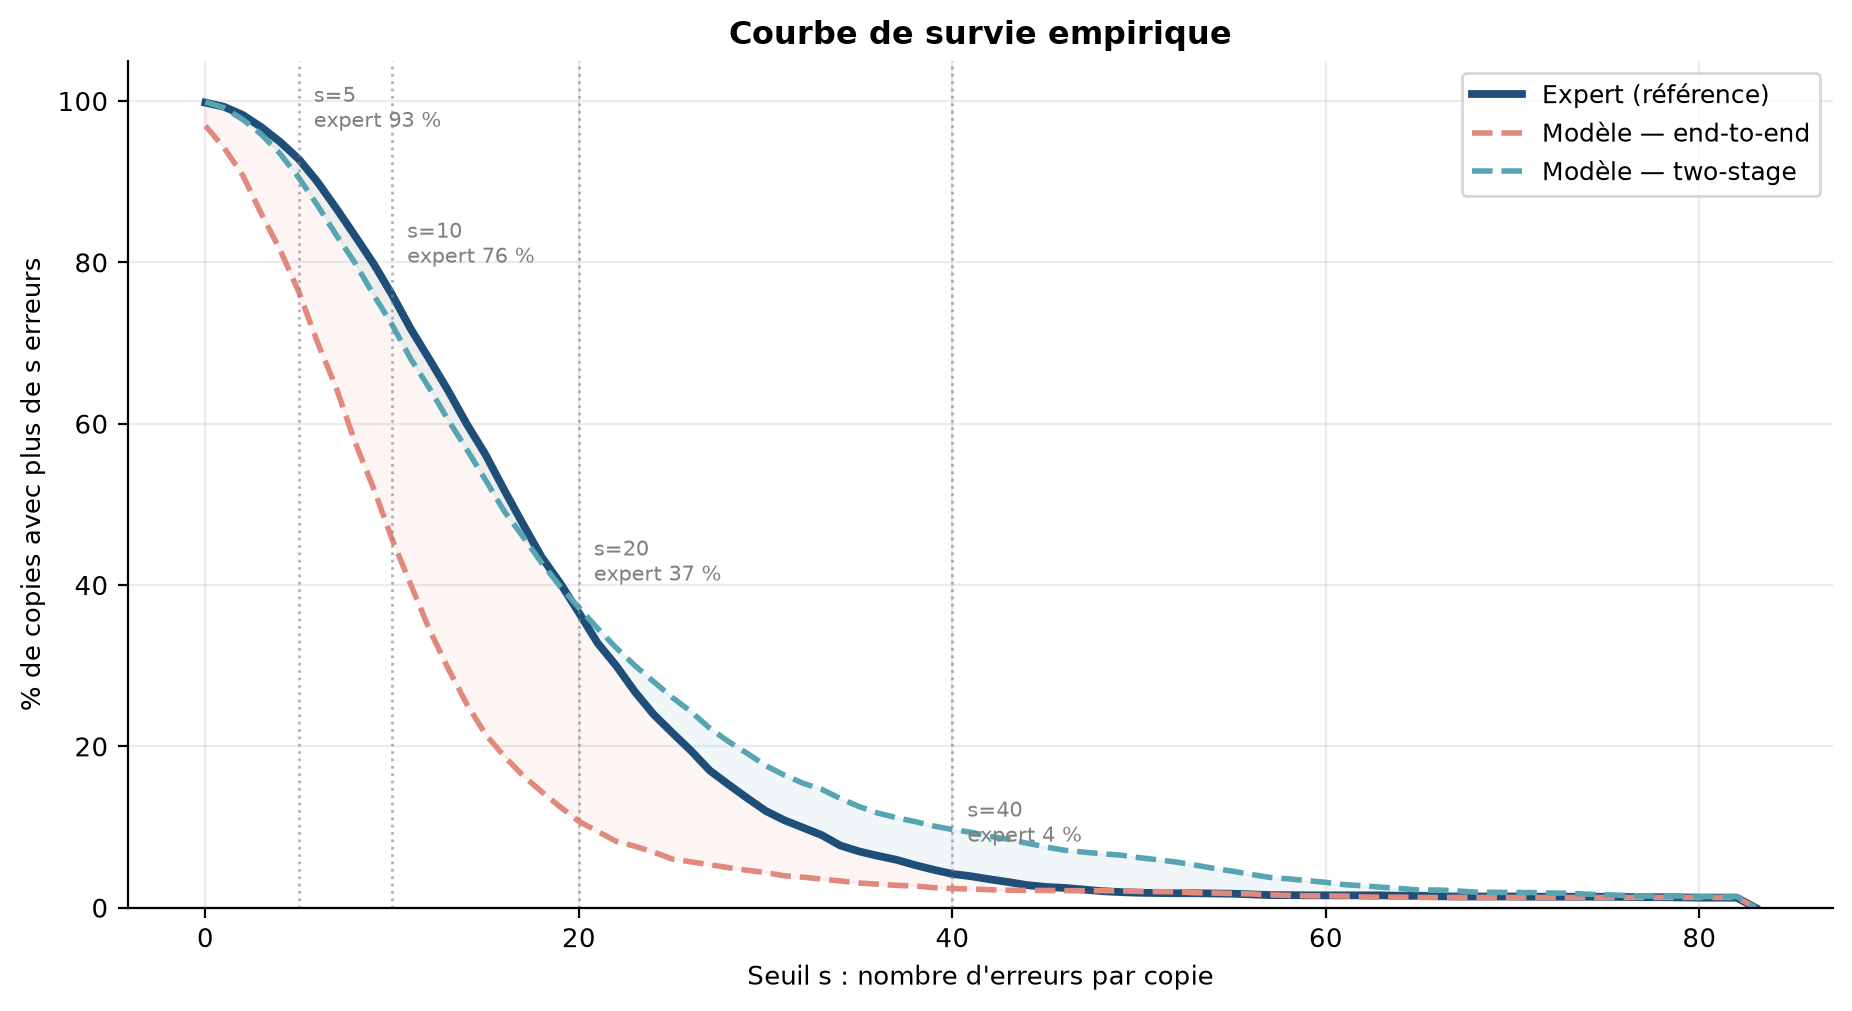
qwen3-6-35b-moe, pour chaque approche.| Nombre d’erreurs par copie | Moyenne | Médiane | Écart-type | Q1 | Q3 | Max |
|---|---|---|---|---|---|---|
| Expert | 18.01 | 17.0 | 9.96 | 11.0 | 24.0 | 76 |
| Modèle — end-to-end | 11.08 | 10.0 | 8.34 | 6.0 | 14.0 | 65 |
| ↳ test de Kolmogorov–Smirnov (end-to-end) | D = 0.350 | p = 3.8e-186 | ||||
| Modèle — two-stage | 19.46 | 16.0 | 13.82 | 10.0 | 25.0 | 83 |
| ↳ test de Kolmogorov–Smirnov (two-stage) | D = 0.060 | p = 8.2e-06 |
Le test de Kolmogorov–Smirnov compare la distribution du modèle à celle de l’expert : une p-valeur très faible signifie que les deux distributions diffèrent, au-delà de leurs seules moyennes.
La courbe de survie chiffre directement ce qui sert au pilotage : la part de copies au-dessus de chaque seuil d’erreurs.
qwen3-6-35b-moe.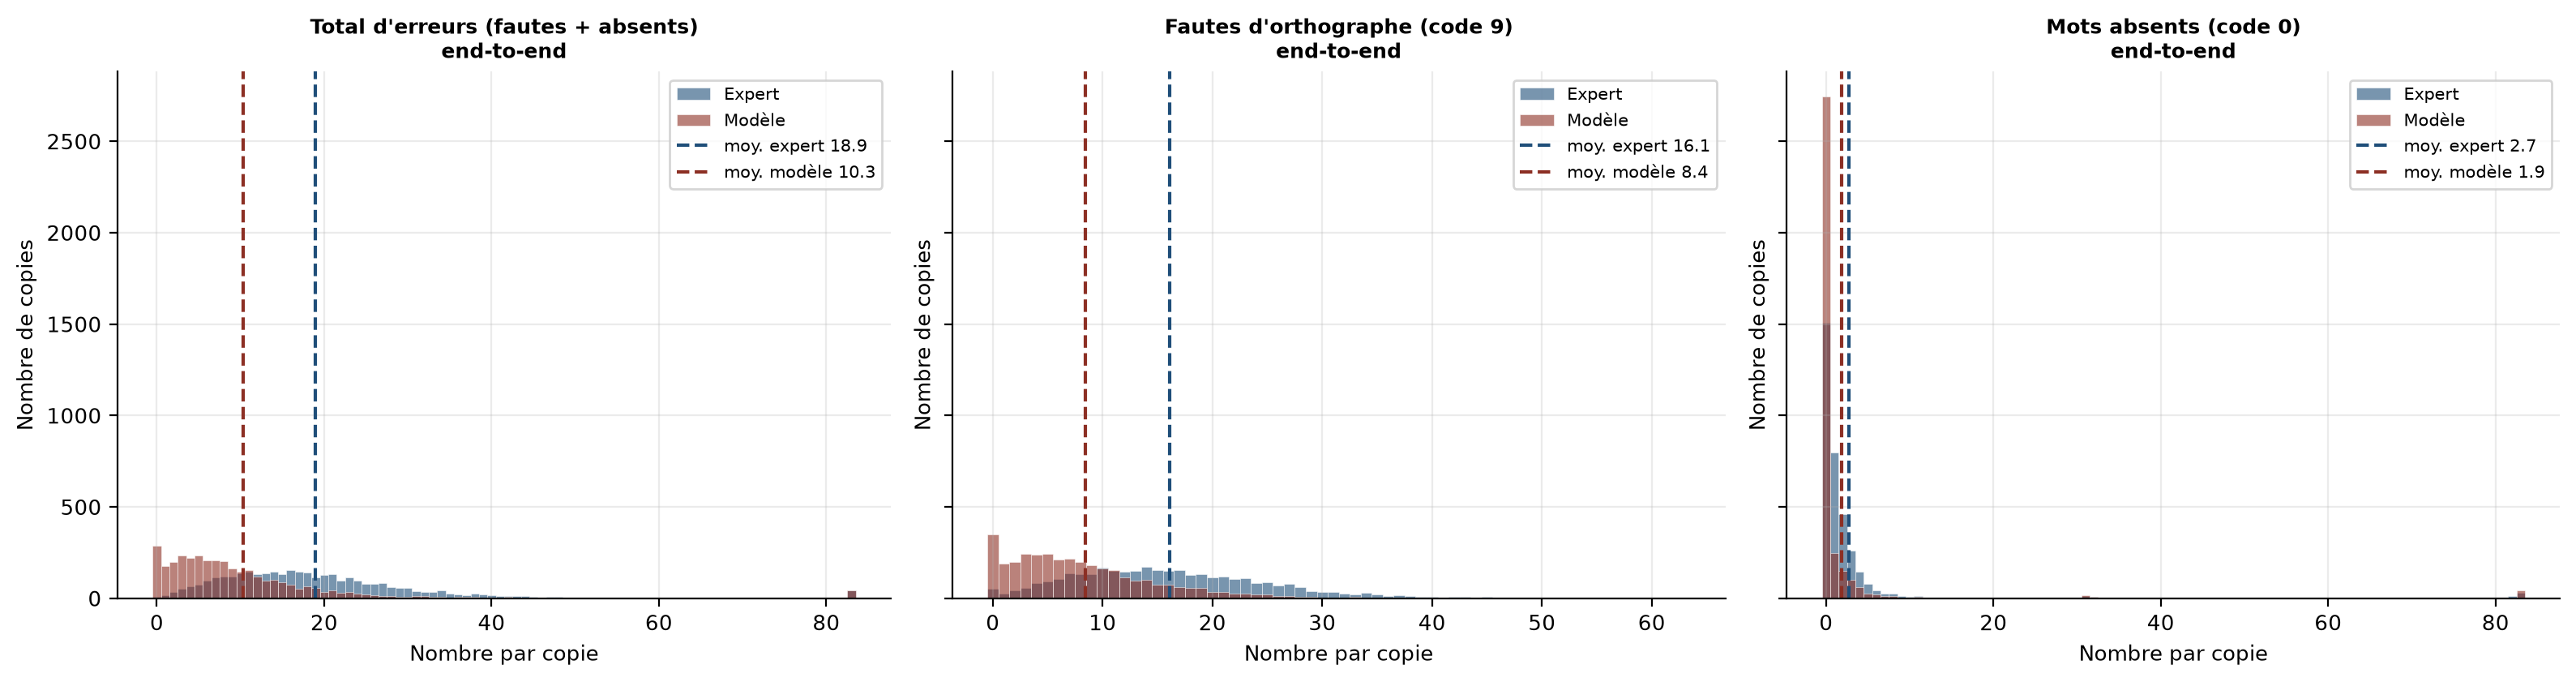
qwen3-8-27b, pour chaque approche.| Nombre d’erreurs par copie | Moyenne | Médiane | Écart-type | Q1 | Q3 | Max |
|---|---|---|---|---|---|---|
| Expert | 18.01 | 17.0 | 9.96 | 11.0 | 24.0 | 76 |
| Modèle — end-to-end | 9.34 | 7.0 | 8.77 | 3.0 | 13.0 | 76 |
| ↳ test de Kolmogorov–Smirnov (end-to-end) | D = 0.421 | p = 1.6e-271 |
Le test de Kolmogorov–Smirnov compare la distribution du modèle à celle de l’expert : une p-valeur très faible signifie que les deux distributions diffèrent, au-delà de leurs seules moyennes.
La courbe de survie chiffre directement ce qui sert au pilotage : la part de copies au-dessus de chaque seuil d’erreurs.
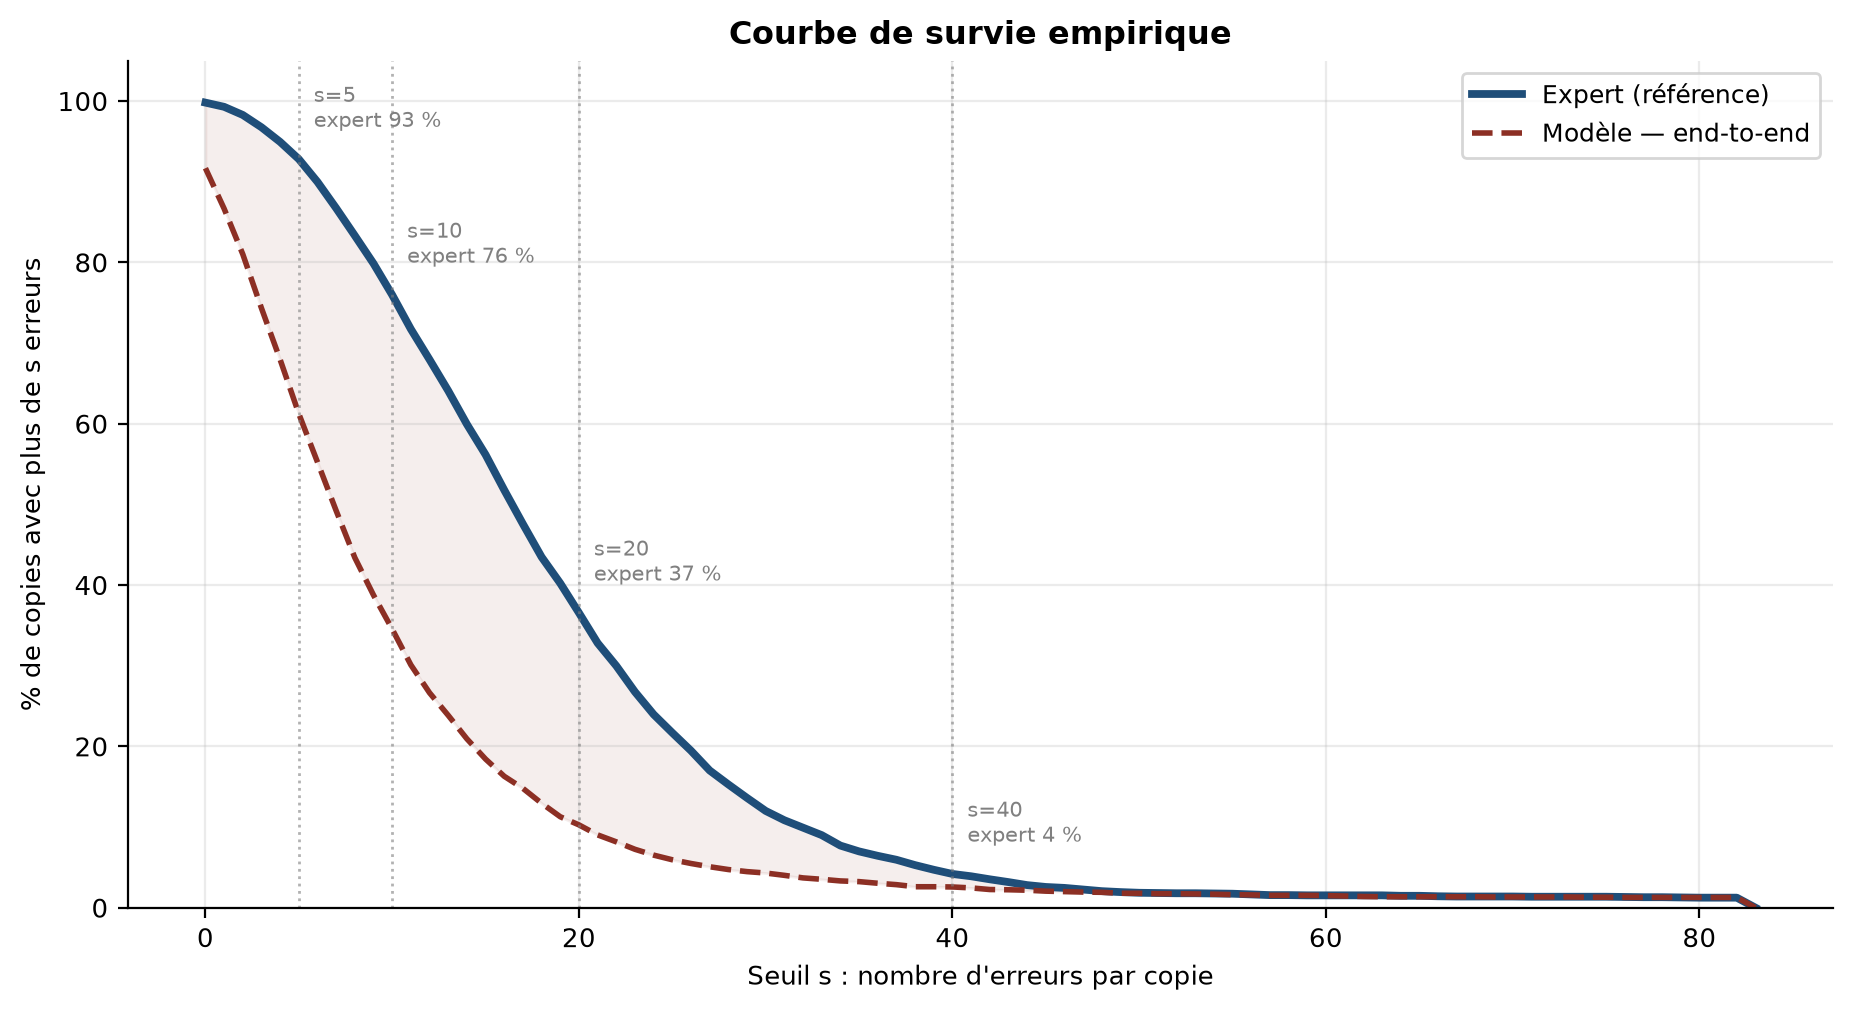
qwen3-8-27b.Nombre d’erreurs modèle vs expert, copie par copie
Objectif DEPP : le modèle reproduit-il le classement des élèves ? Une corrélation forte et une pente proche de 1 signent un classement fidèle, même si le niveau absolu est biaisé.
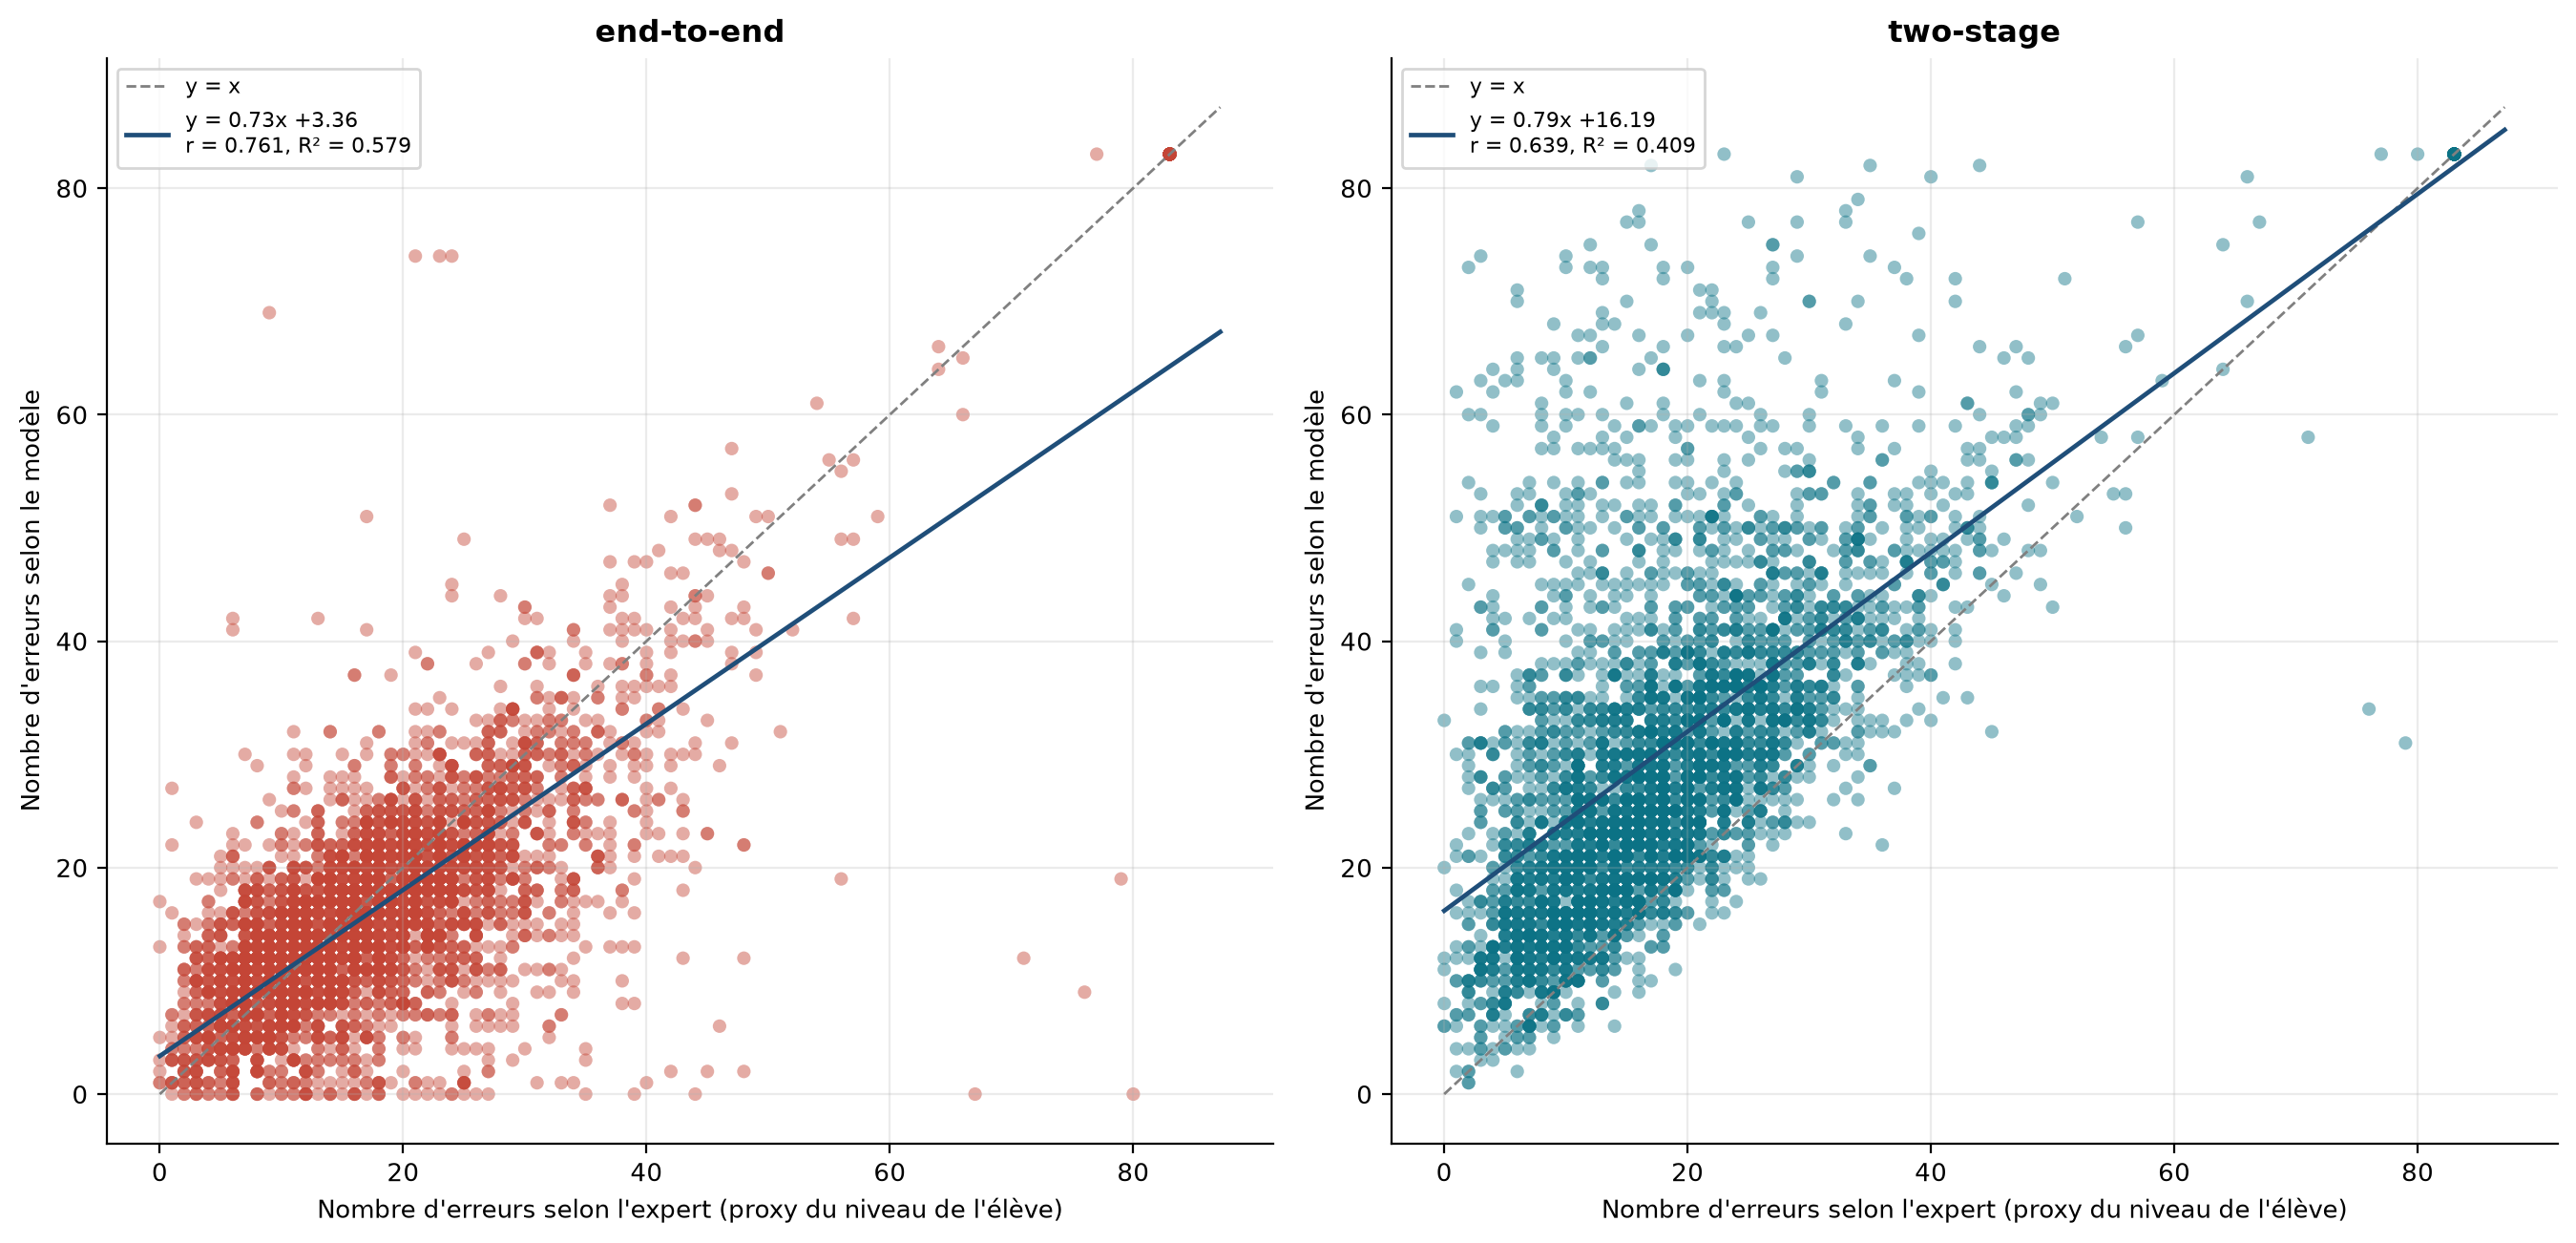
gemma4-26b-moe vs expert. Chaque point est une copie.| Approche | Pearson r | Spearman ρ | Kendall τ | Pente | R² |
|---|---|---|---|---|---|
| end-to-end | +0.641 | +0.617 | +0.465 | 0.607 | 0.411 |
| two-stage | +0.550 | +0.581 | +0.441 | 0.784 | 0.303 |
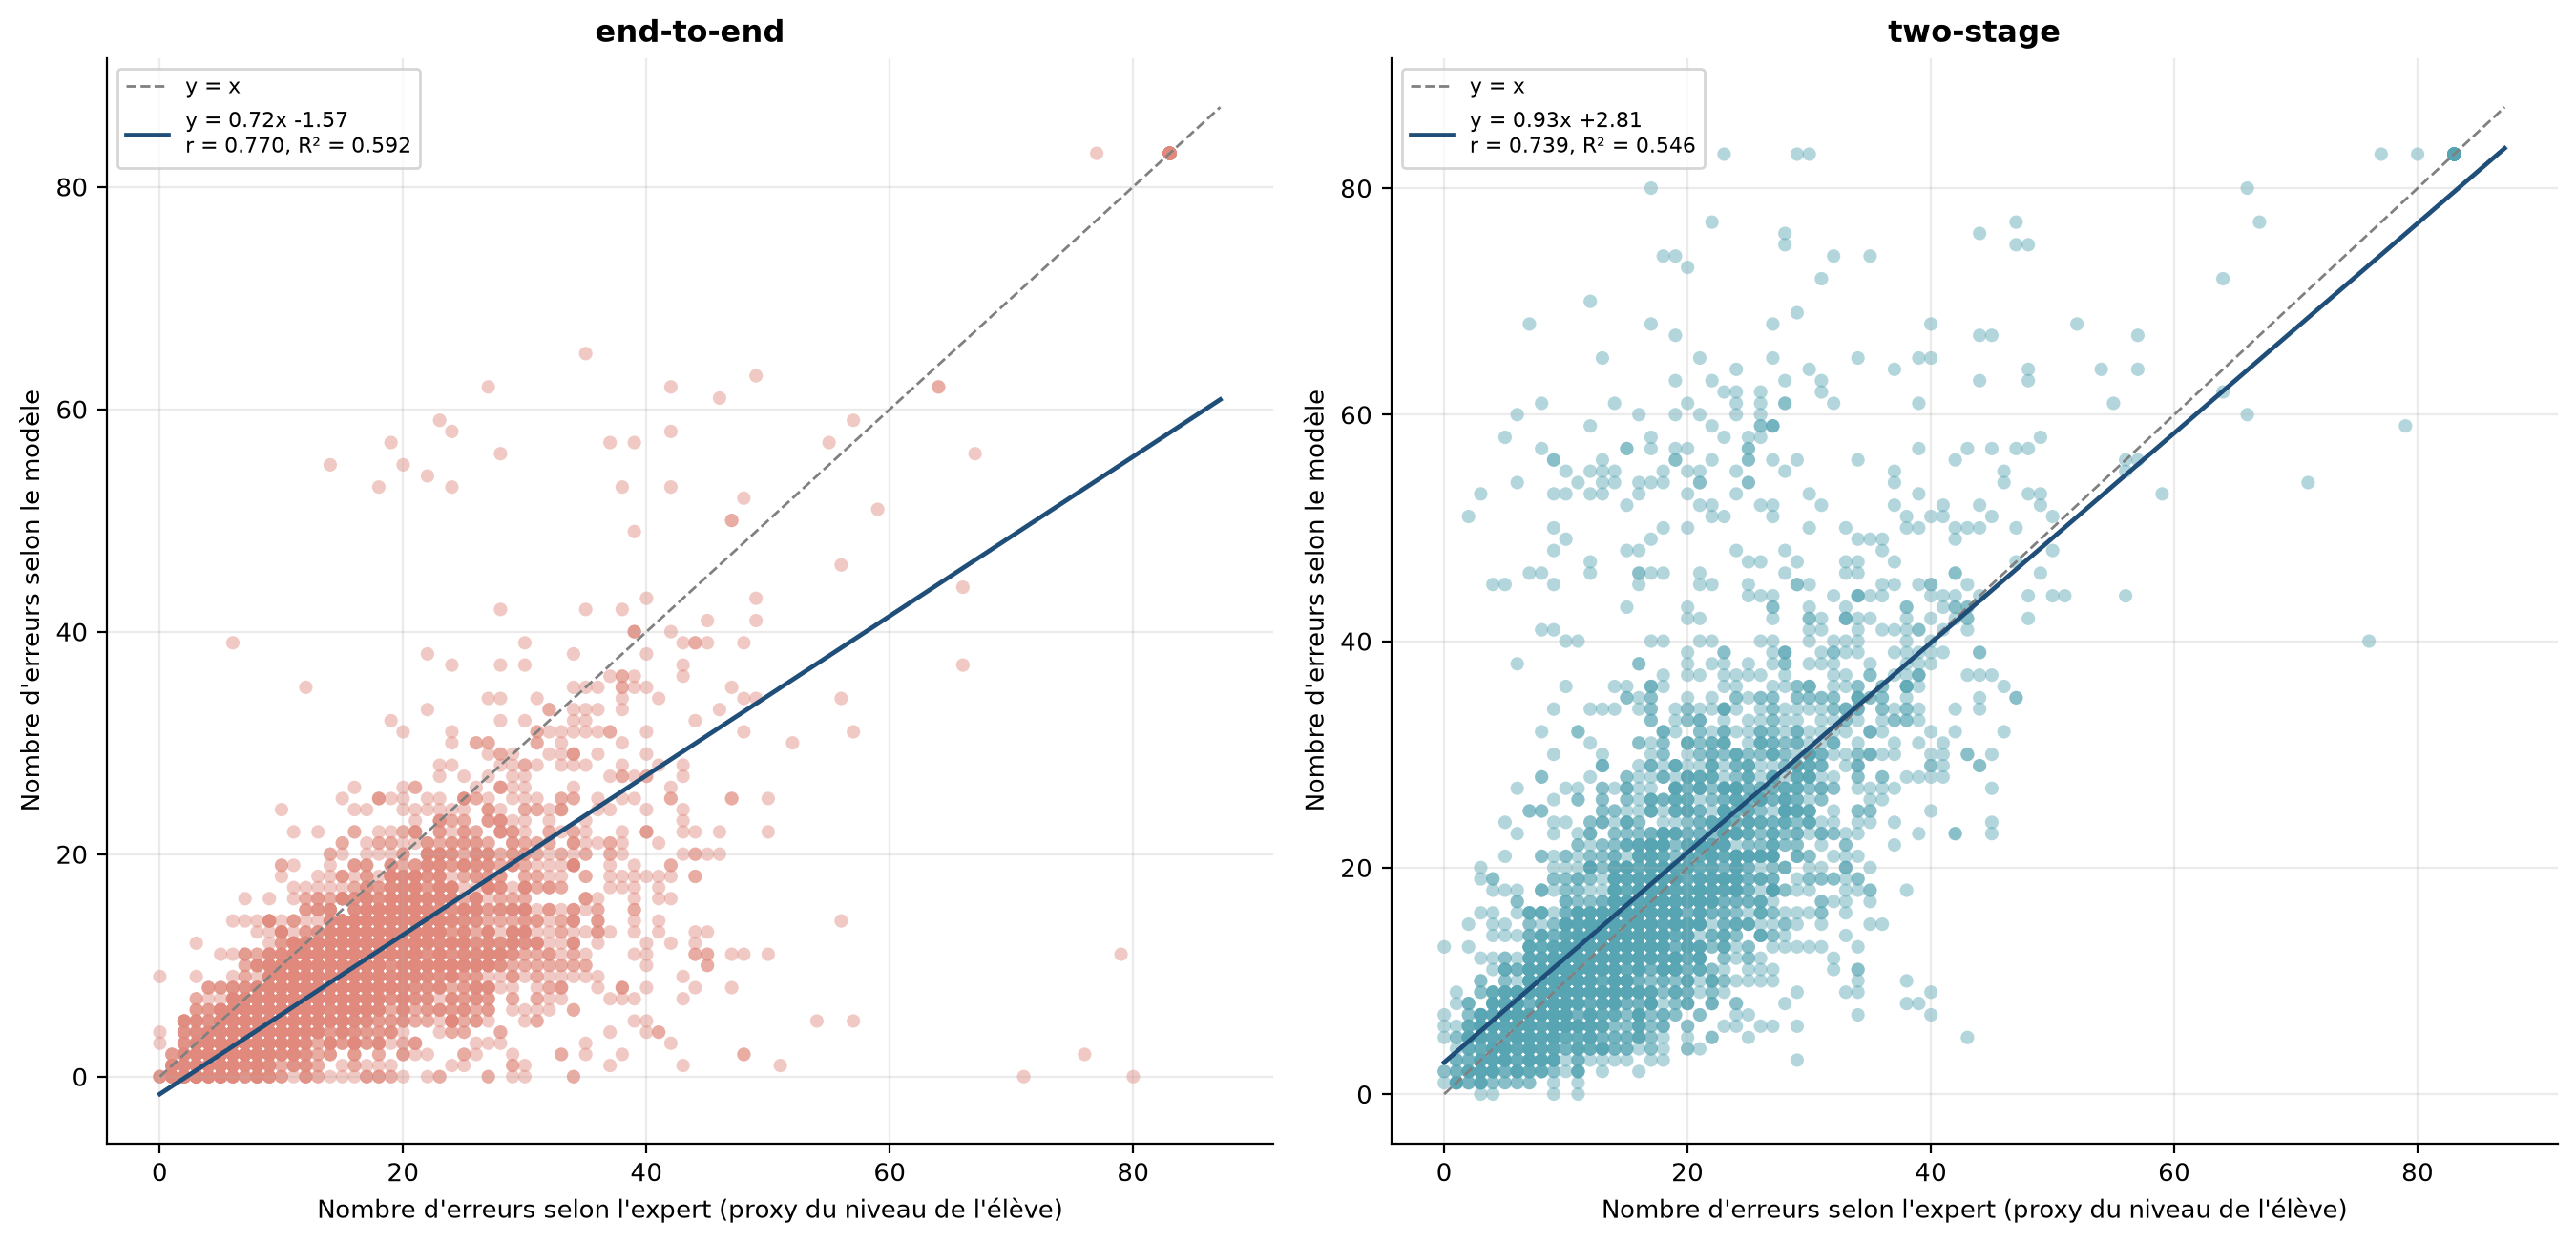
qwen3-6-35b-moe vs expert. Chaque point est une copie.| Approche | Pearson r | Spearman ρ | Kendall τ | Pente | R² |
|---|---|---|---|---|---|
| end-to-end | +0.641 | +0.673 | +0.515 | 0.536 | 0.411 |
| two-stage | +0.648 | +0.718 | +0.553 | 0.899 | 0.420 |
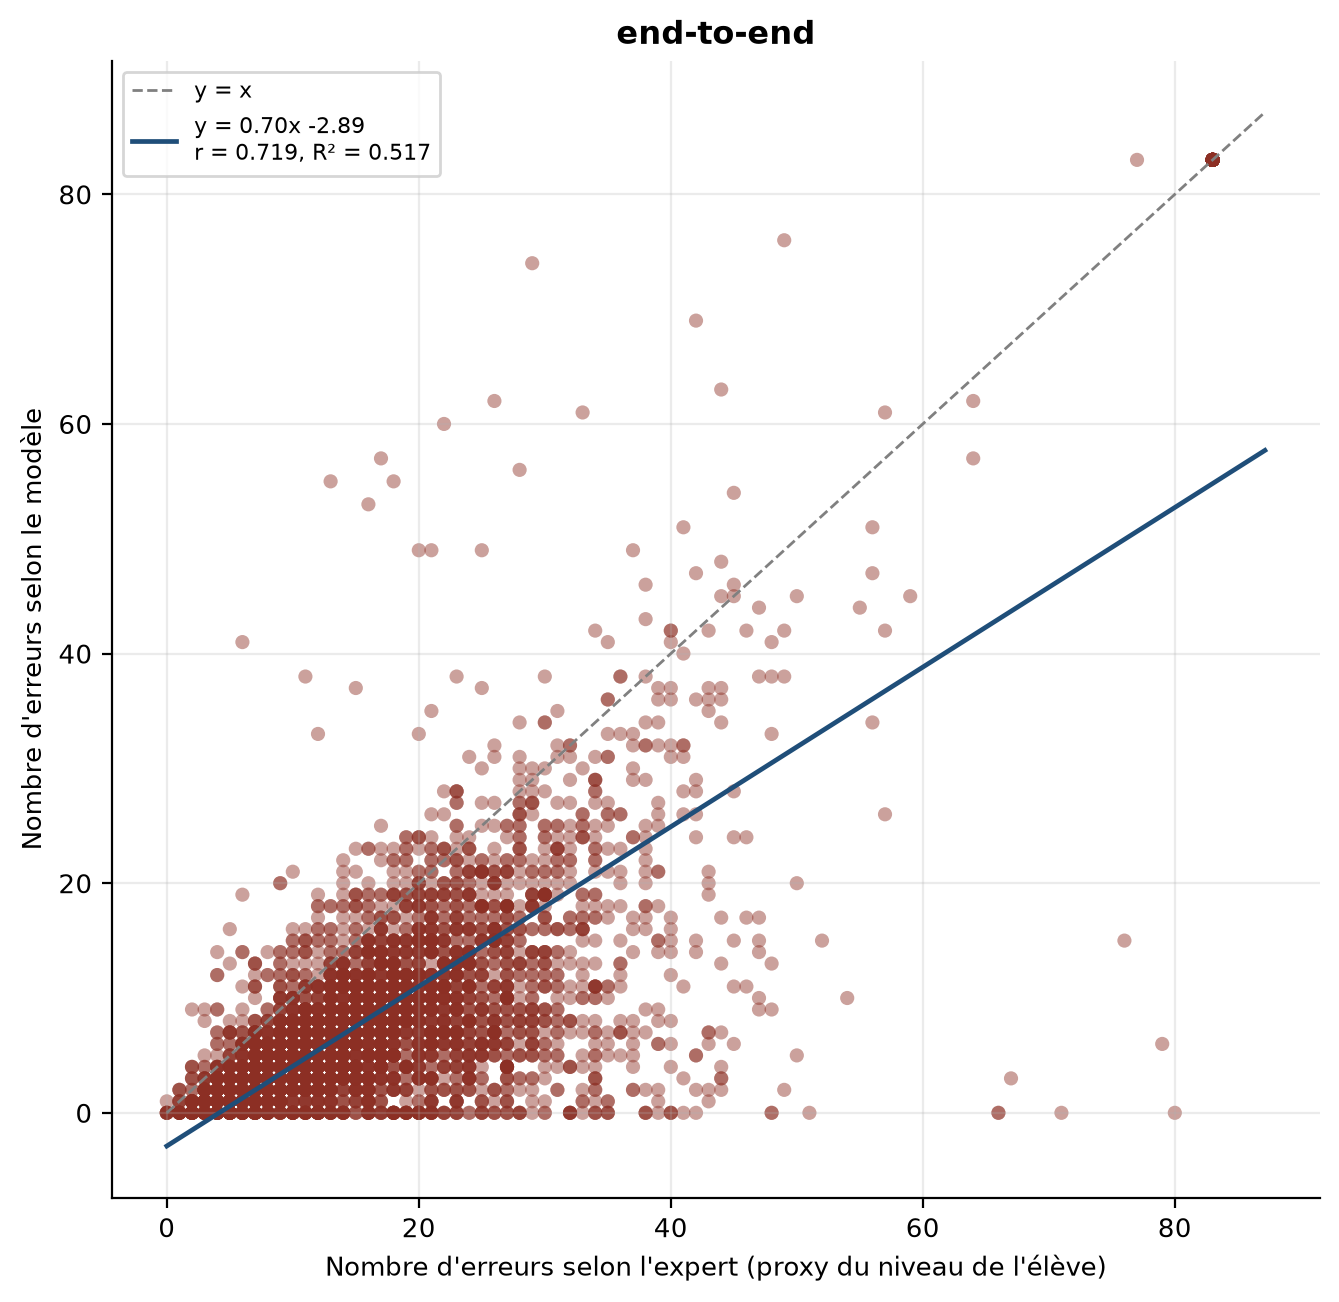
qwen3-8-27b vs expert. Chaque point est une copie.| Approche | Pearson r | Spearman ρ | Kendall τ | Pente | R² |
|---|---|---|---|---|---|
| end-to-end | +0.556 | +0.550 | +0.416 | 0.490 | 0.309 |
Métriques d’accord selon la difficulté de la copie
L’accord se dégrade-t-il sur les copies difficiles ? On découpe les copies en huit groupes de difficulté croissante, une fois selon le nombre d’erreurs vues par l’expert (difficulté réelle), une fois selon celui vu par le modèle (difficulté perçue).
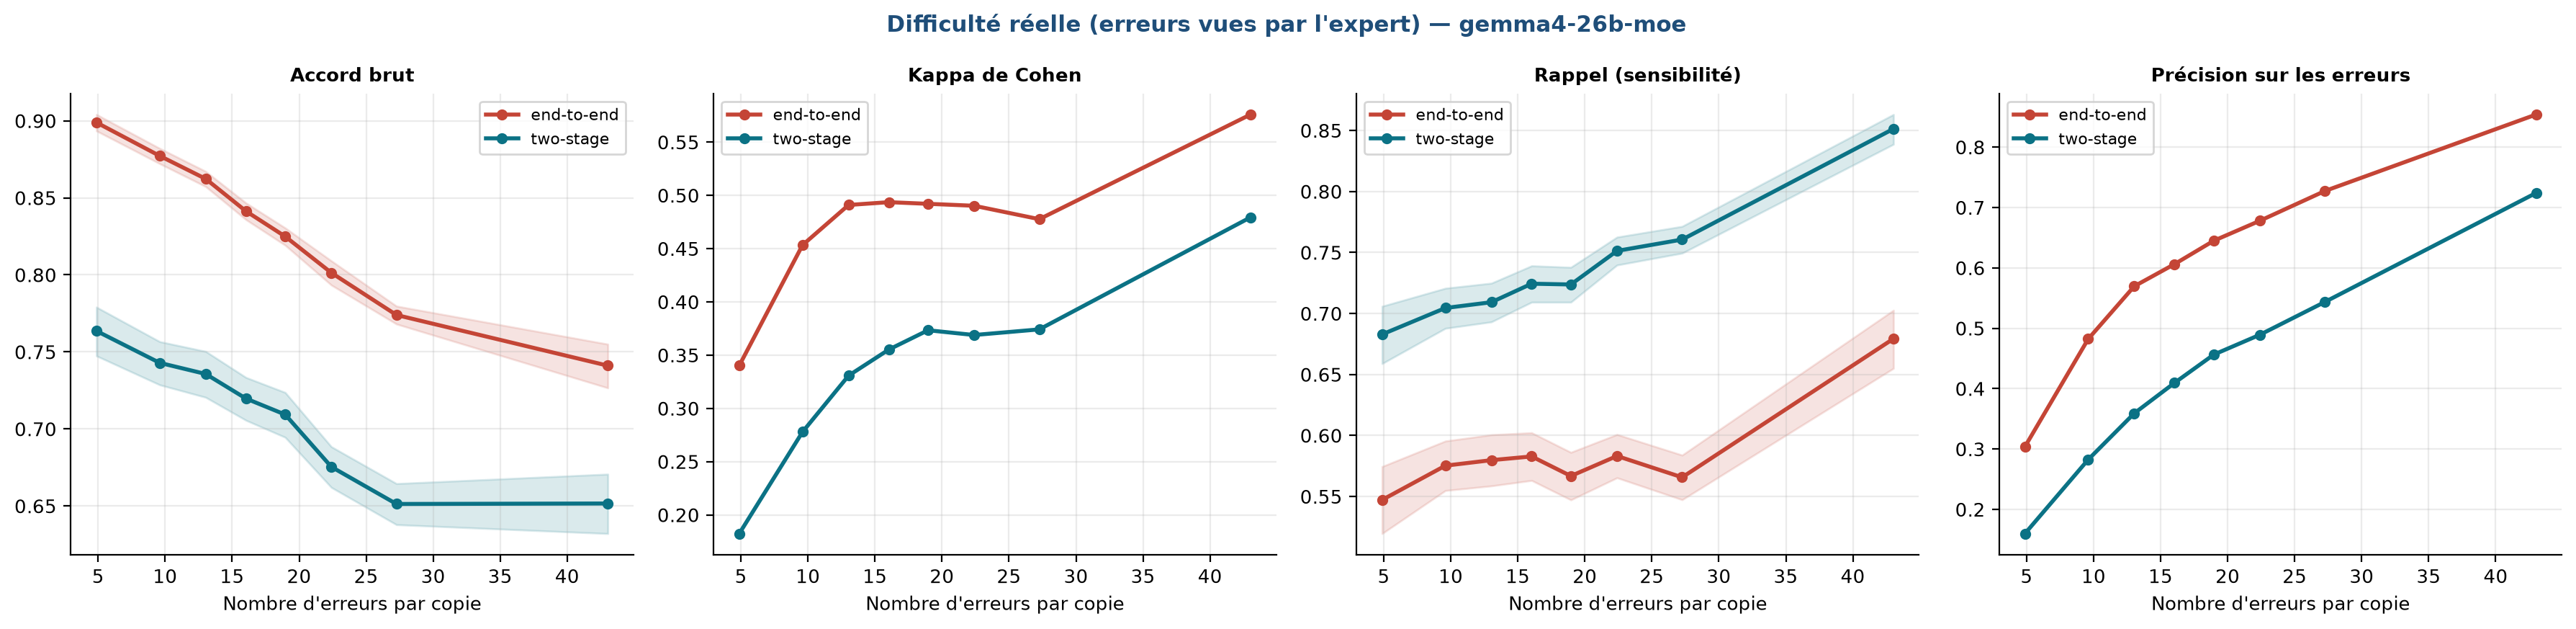
gemma4-26b-moe. Zone ombrée = IC Wilson 95 %.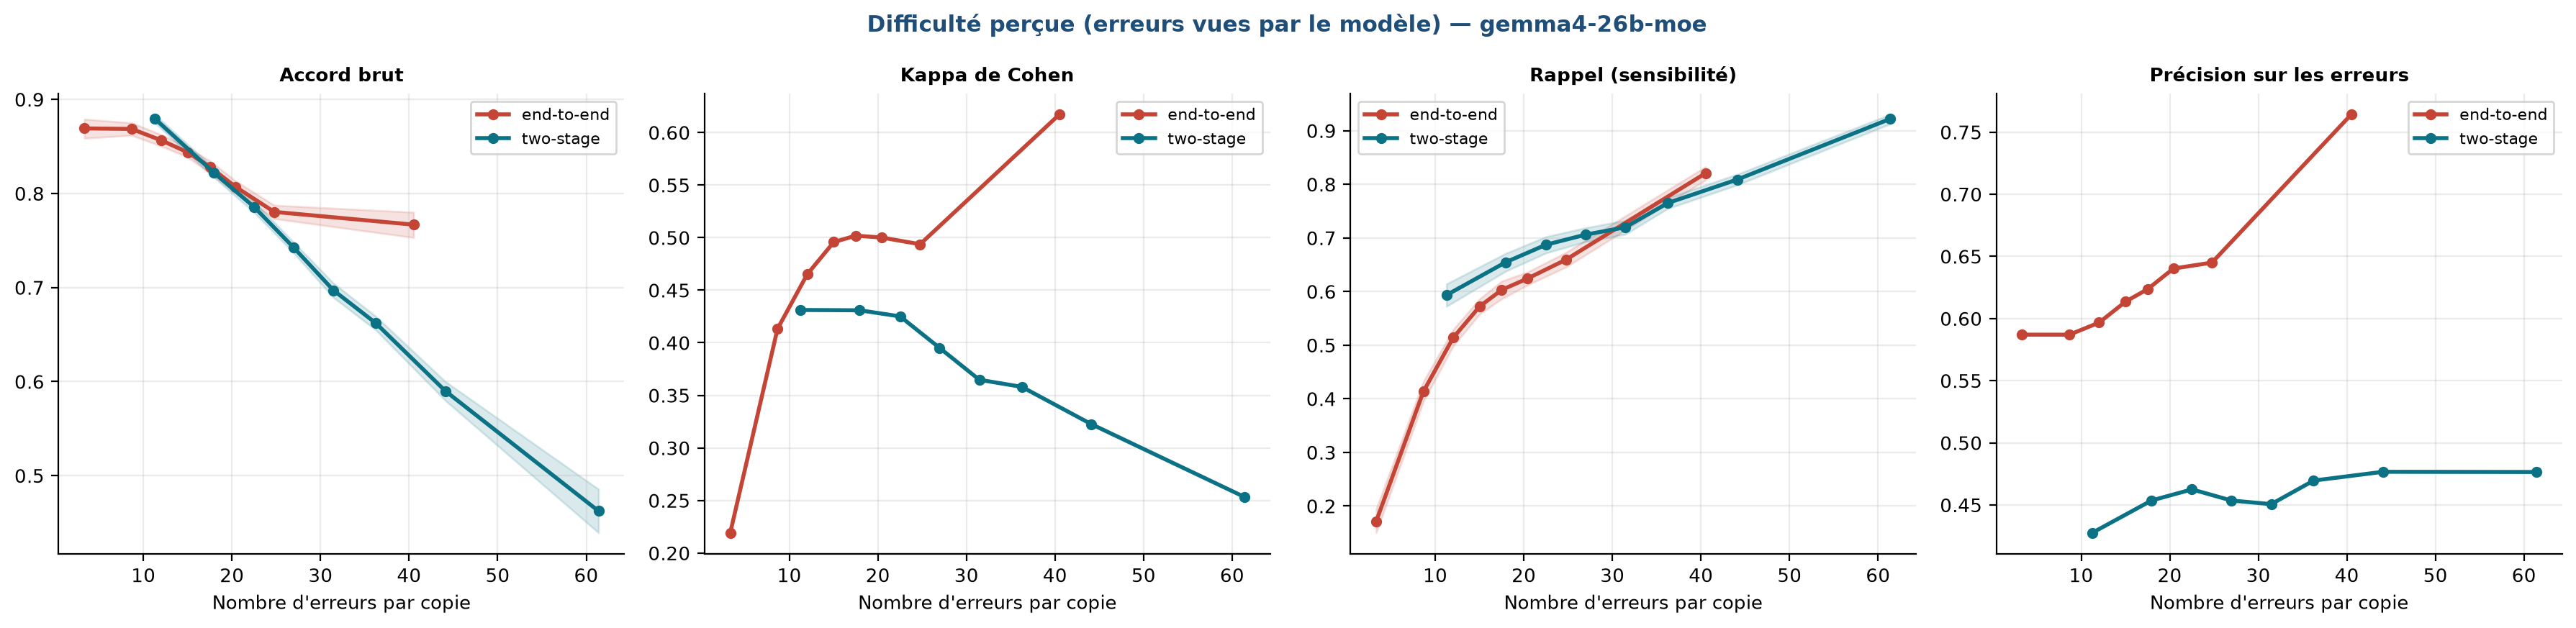
gemma4-26b-moe. Zone ombrée = IC Wilson 95 %.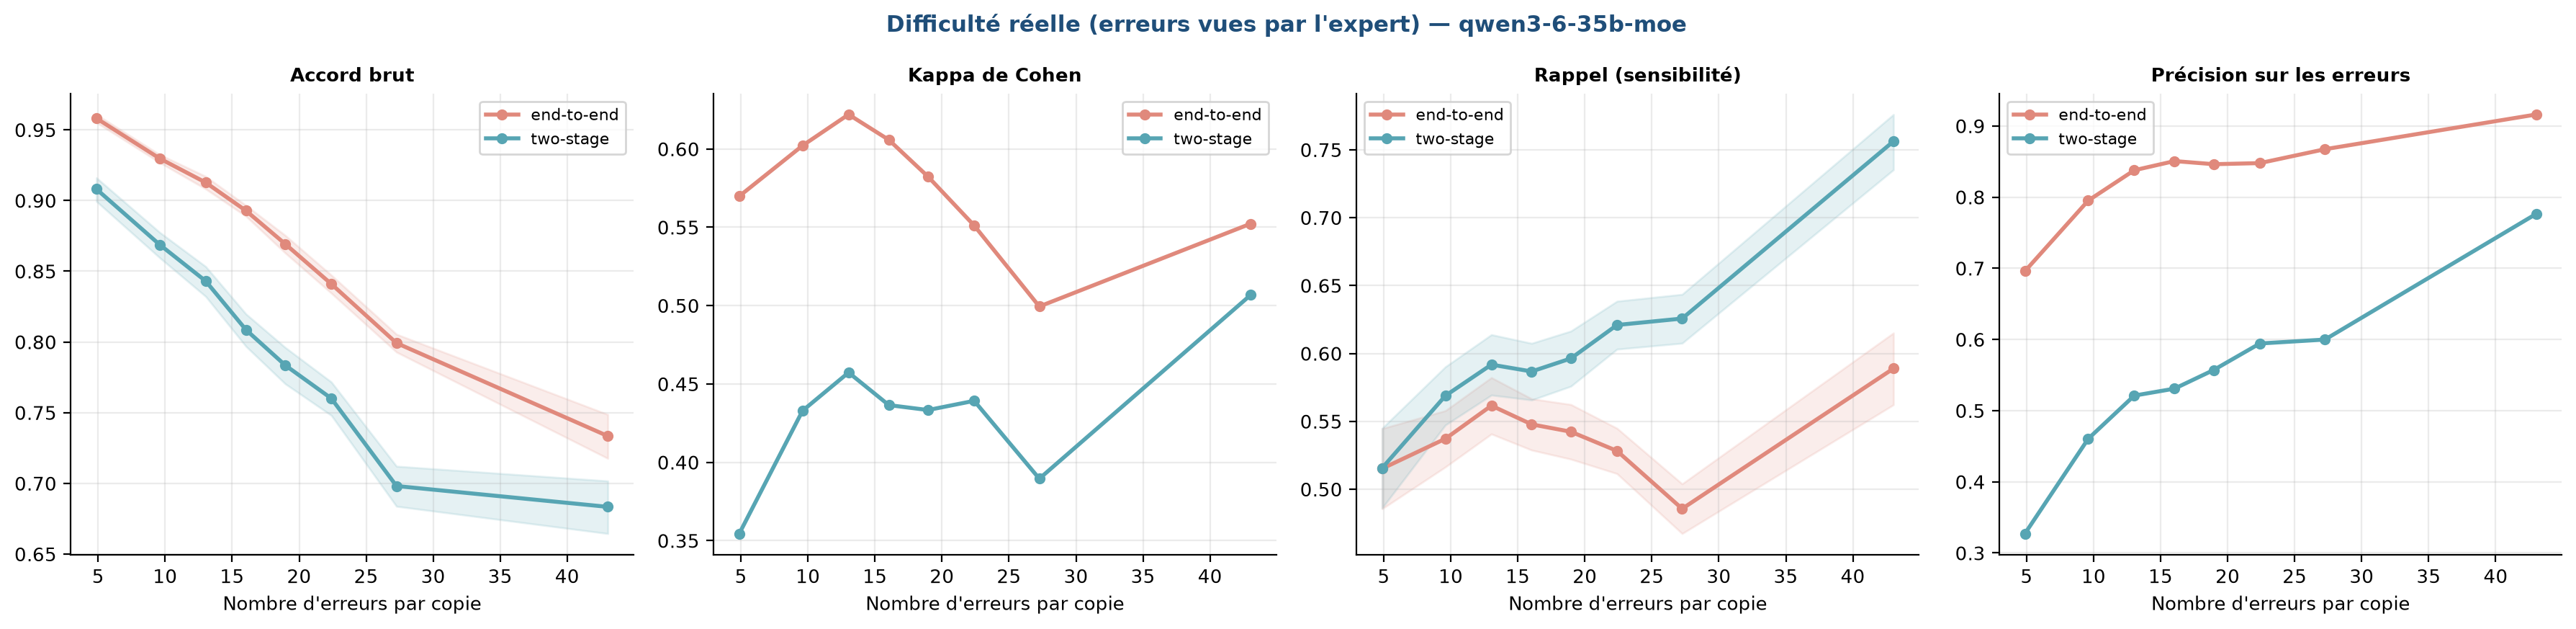
qwen3-6-35b-moe. Zone ombrée = IC Wilson 95 %.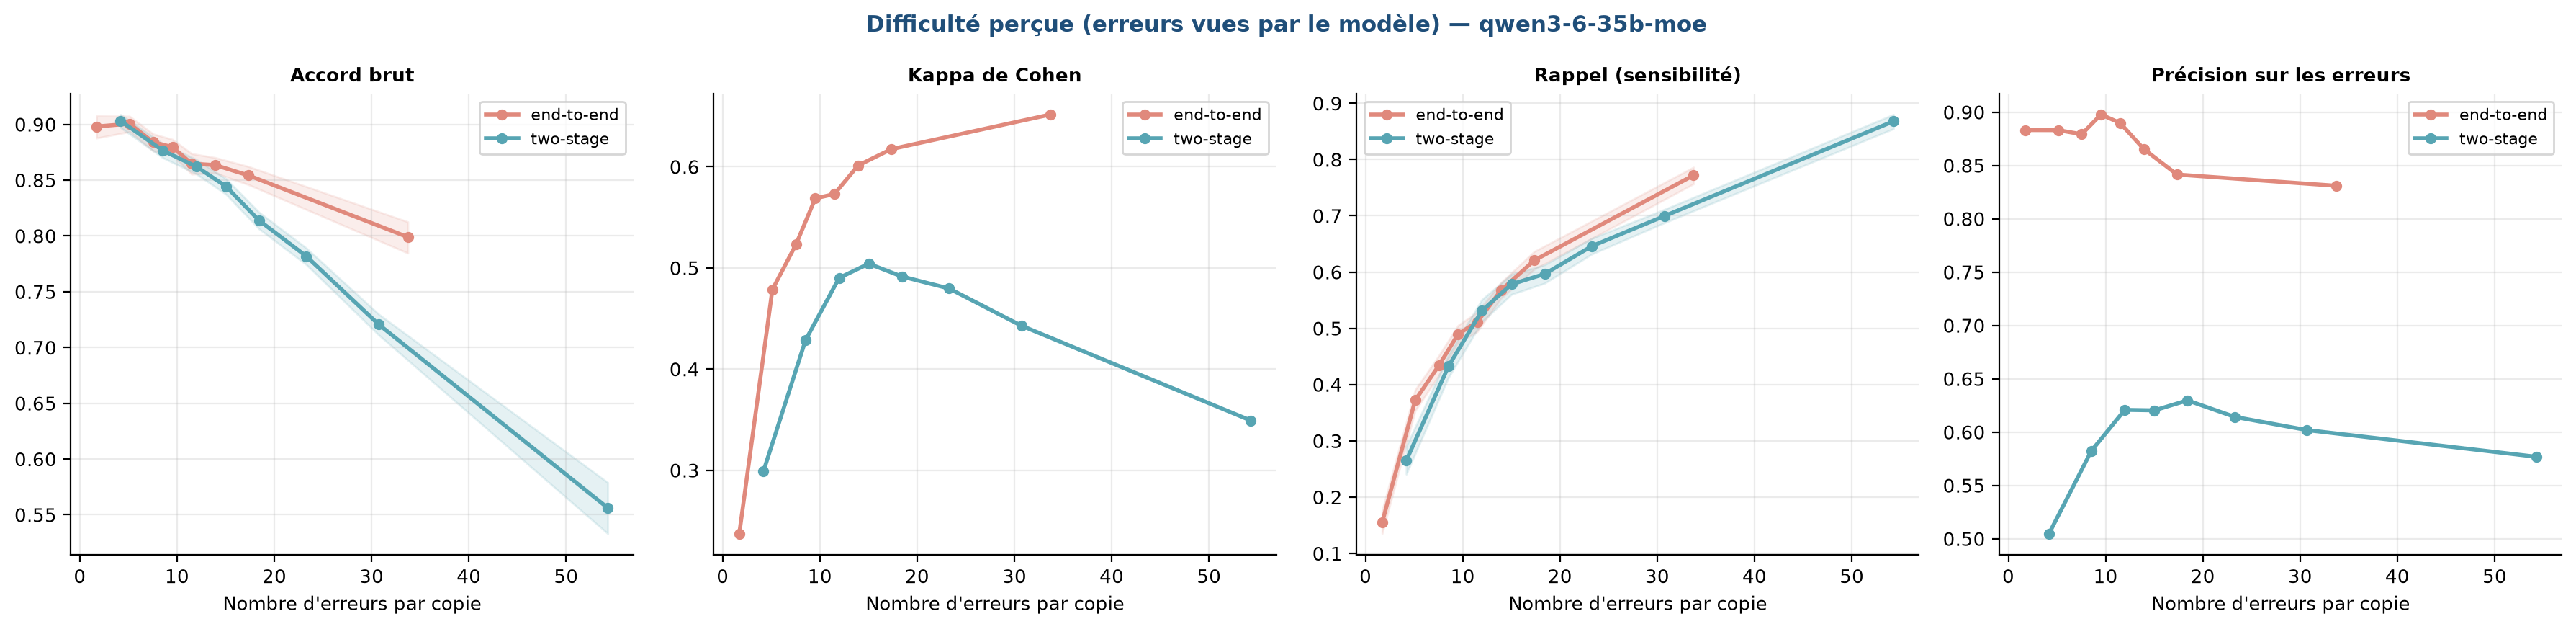
qwen3-6-35b-moe. Zone ombrée = IC Wilson 95 %.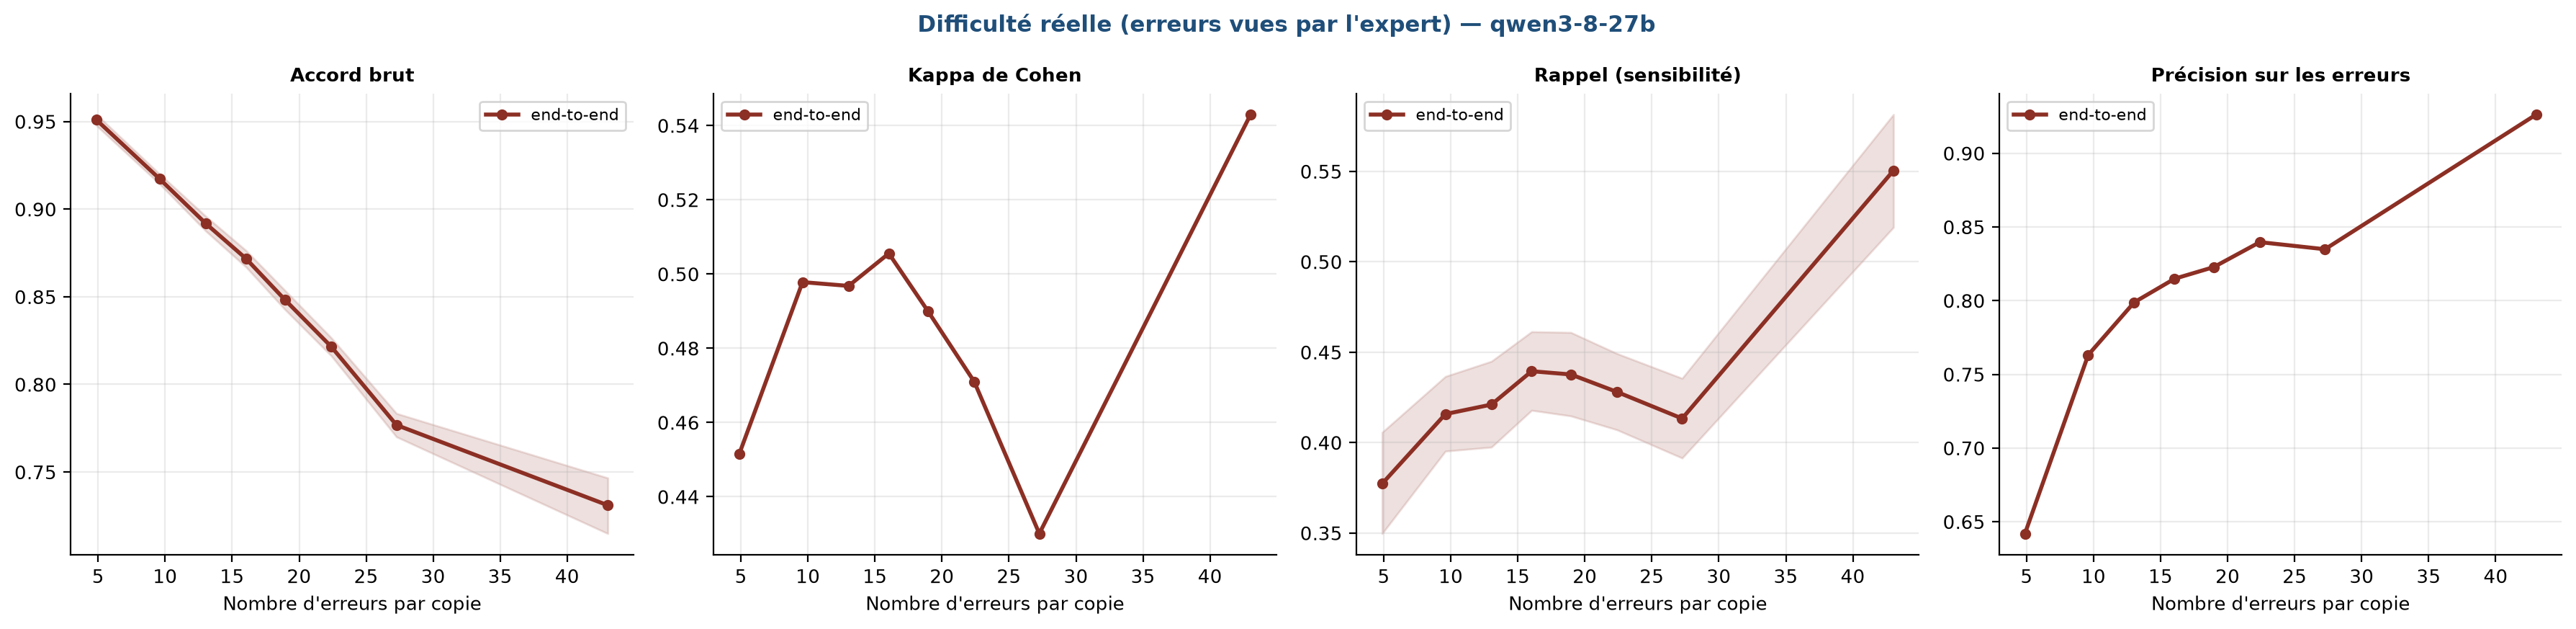
qwen3-8-27b. Zone ombrée = IC Wilson 95 %.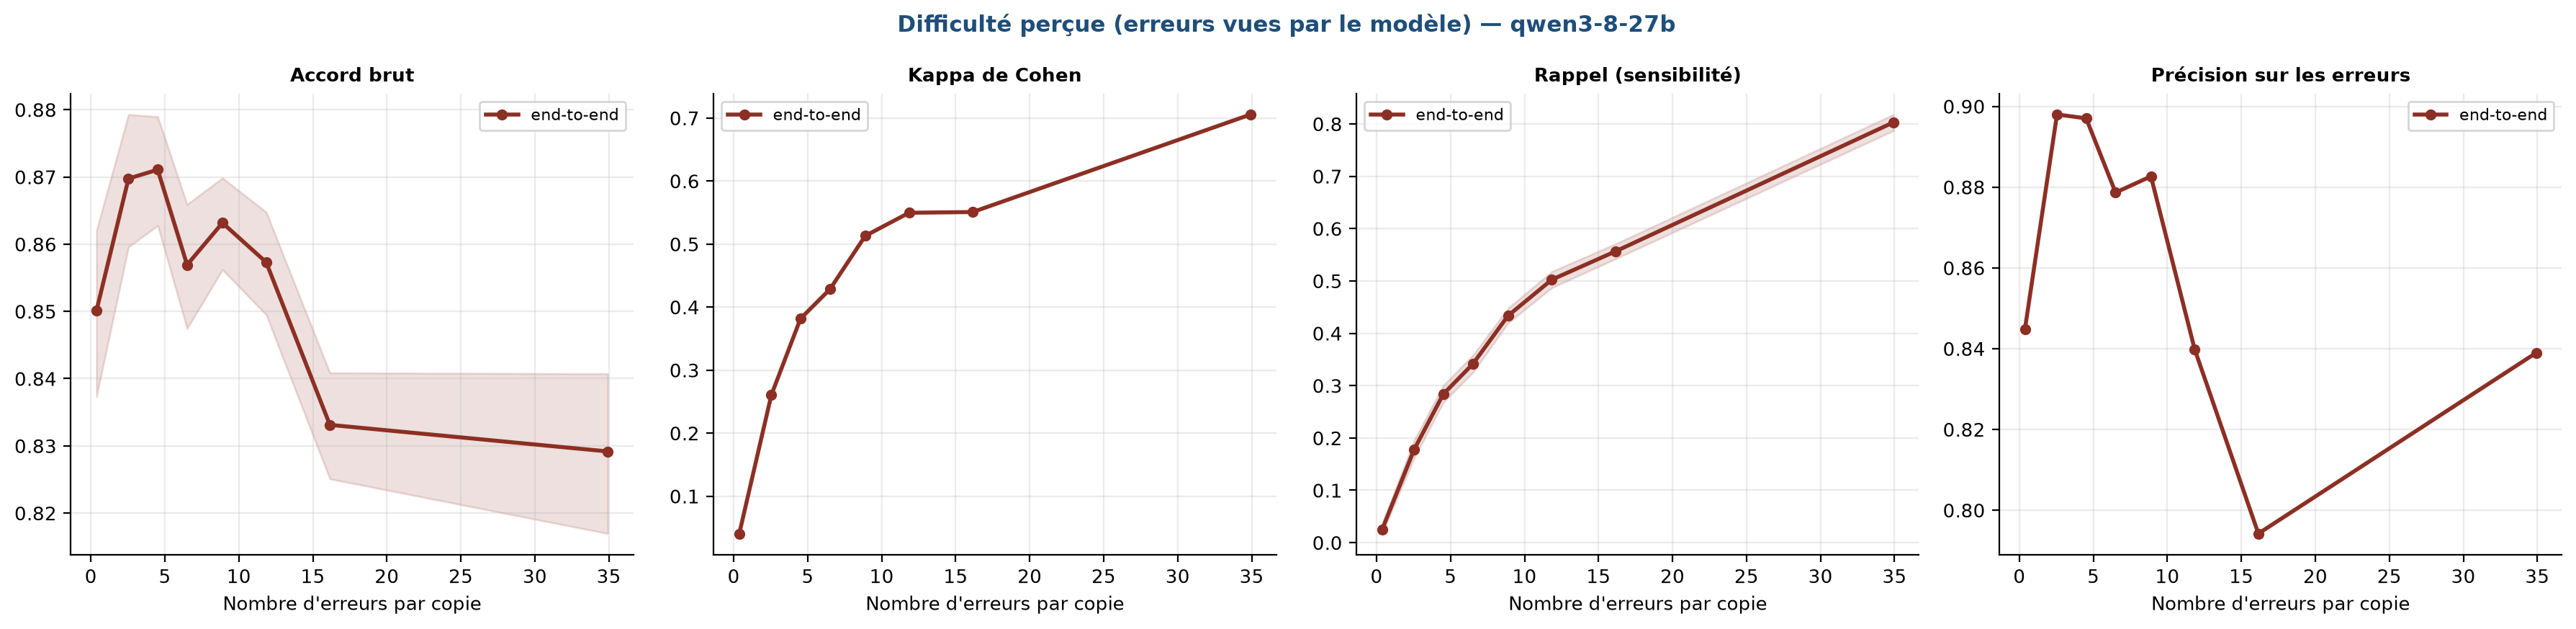
qwen3-8-27b. Zone ombrée = IC Wilson 95 %.Décomposition des désaccords
Chaque désaccord n’a pas les mêmes conséquences : sur-correction (expert : erreur → modèle : correct) veut dire qu’une faute de l’élève est passée inaperçue ; sur-détection (expert : correct → modèle : erreur) veut dire qu’on sanctionne un élève à tort. Le tableau détaille chaque transition code expert → code modèle, soit la matrice de confusion mise à plat.
| Transition expert → modèle | end-to-end | two-stage |
|---|---|---|
expert:9 → modèle:1 |
22 694 (46.9 %) | 14 619 (17.5 %) |
expert:1 → modèle:9 |
15 737 (32.5 %) | 19 242 (23.0 %) |
expert:1 → modèle:0 |
4 380 (9.0 %) | 38 560 (46.2 %) |
expert:0 → modèle:1 |
3 097 (6.4 %) | 716 (0.9 %) |
expert:9 → modèle:0 |
1 838 (3.8 %) | 9 819 (11.8 %) |
expert:0 → modèle:9 |
424 (0.9 %) | 494 (0.6 %) |
expert:1 → modèle:? |
168 (0.3 %) | 75 (0.1 %) |
expert:9 → modèle:? |
62 (0.1 %) | 17 (0.0 %) |
expert:0 → modèle:? |
1 (0.0 %) | 1 (0.0 %) |
| Transition expert → modèle | end-to-end | two-stage |
|---|---|---|
expert:9 → modèle:1 |
25 727 (69.8 %) | 22 255 (38.6 %) |
expert:1 → modèle:9 |
4 455 (12.1 %) | 12 037 (20.9 %) |
expert:0 → modèle:1 |
3 856 (10.5 %) | 1 128 (2.0 %) |
expert:1 → modèle:0 |
1 383 (3.8 %) | 16 311 (28.3 %) |
expert:9 → modèle:0 |
1 141 (3.1 %) | 5 299 (9.2 %) |
expert:0 → modèle:9 |
246 (0.7 %) | 591 (1.0 %) |
expert:1 → modèle:? |
44 (0.1 %) | 21 (0.0 %) |
expert:9 → modèle:? |
14 (0.0 %) | 4 (0.0 %) |
expert:0 → modèle:? |
6 (0.0 %) | 1 (0.0 %) |
| Transition expert → modèle | end-to-end |
|---|---|
expert:9 → modèle:1 |
31 728 (76.7 %) |
expert:1 → modèle:9 |
5 168 (12.5 %) |
expert:0 → modèle:1 |
3 491 (8.4 %) |
expert:1 → modèle:0 |
356 (0.9 %) |
expert:9 → modèle:0 |
334 (0.8 %) |
expert:0 → modèle:9 |
259 (0.6 %) |
expert:1 → modèle:? |
30 (0.1 %) |
expert:9 → modèle:? |
8 (0.0 %) |
Accord par item
Accord entre modèle et expert pour chacun des 83 items, avec intervalle de Wilson à 95 %. Les items sont triés par accord croissant selon l’approche de référence : ceux du haut du graphique sont les plus problématiques.
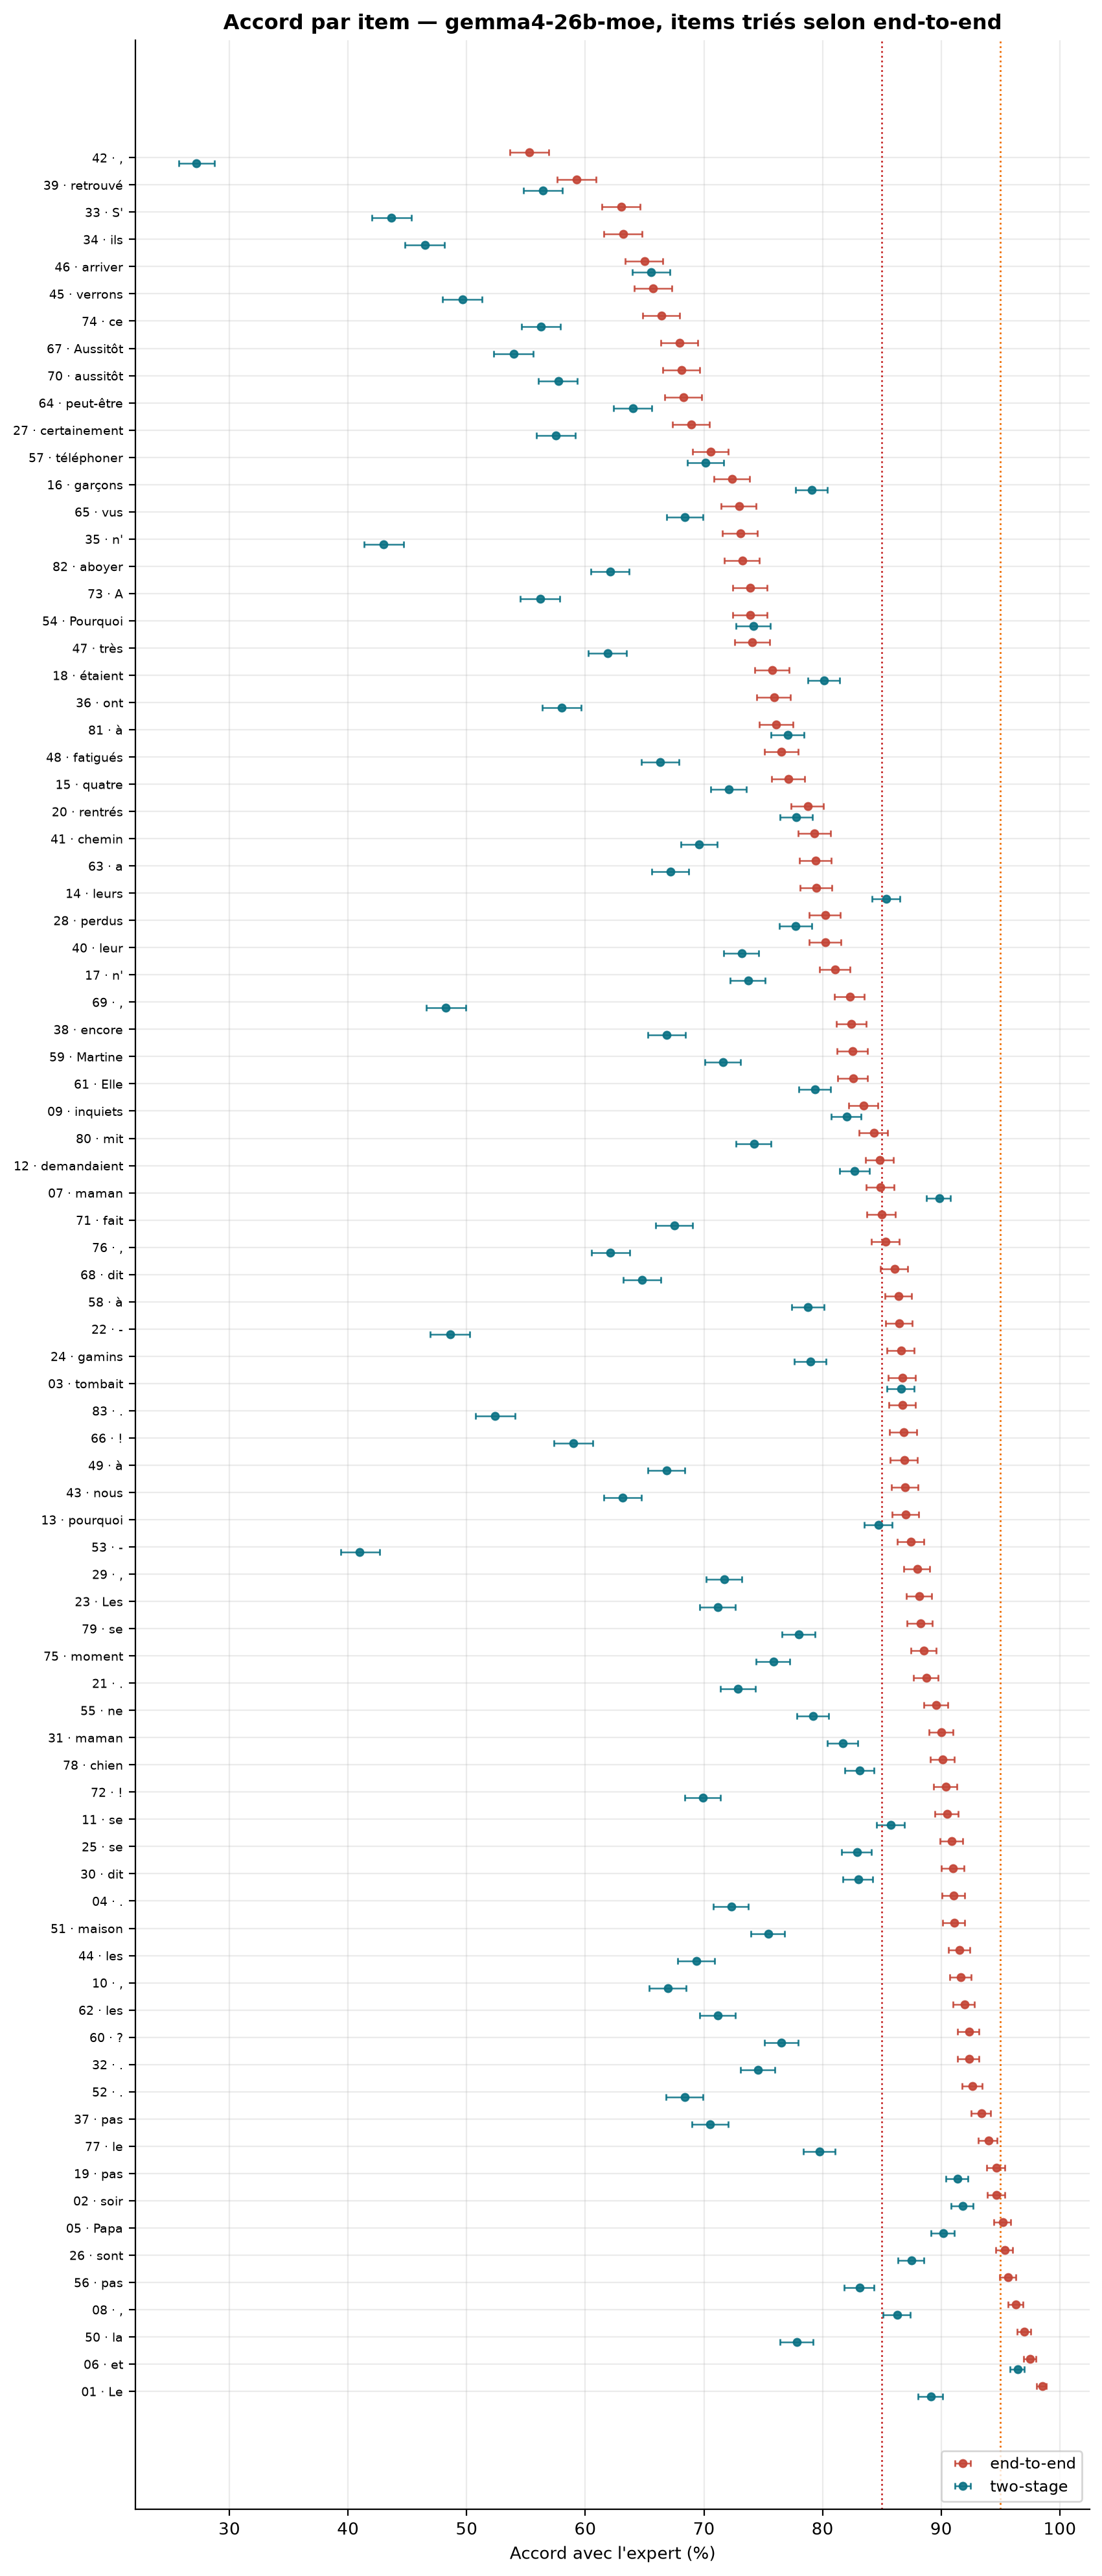
gemma4-26b-moe, trié par accord croissant. Barres = IC Wilson 95 %.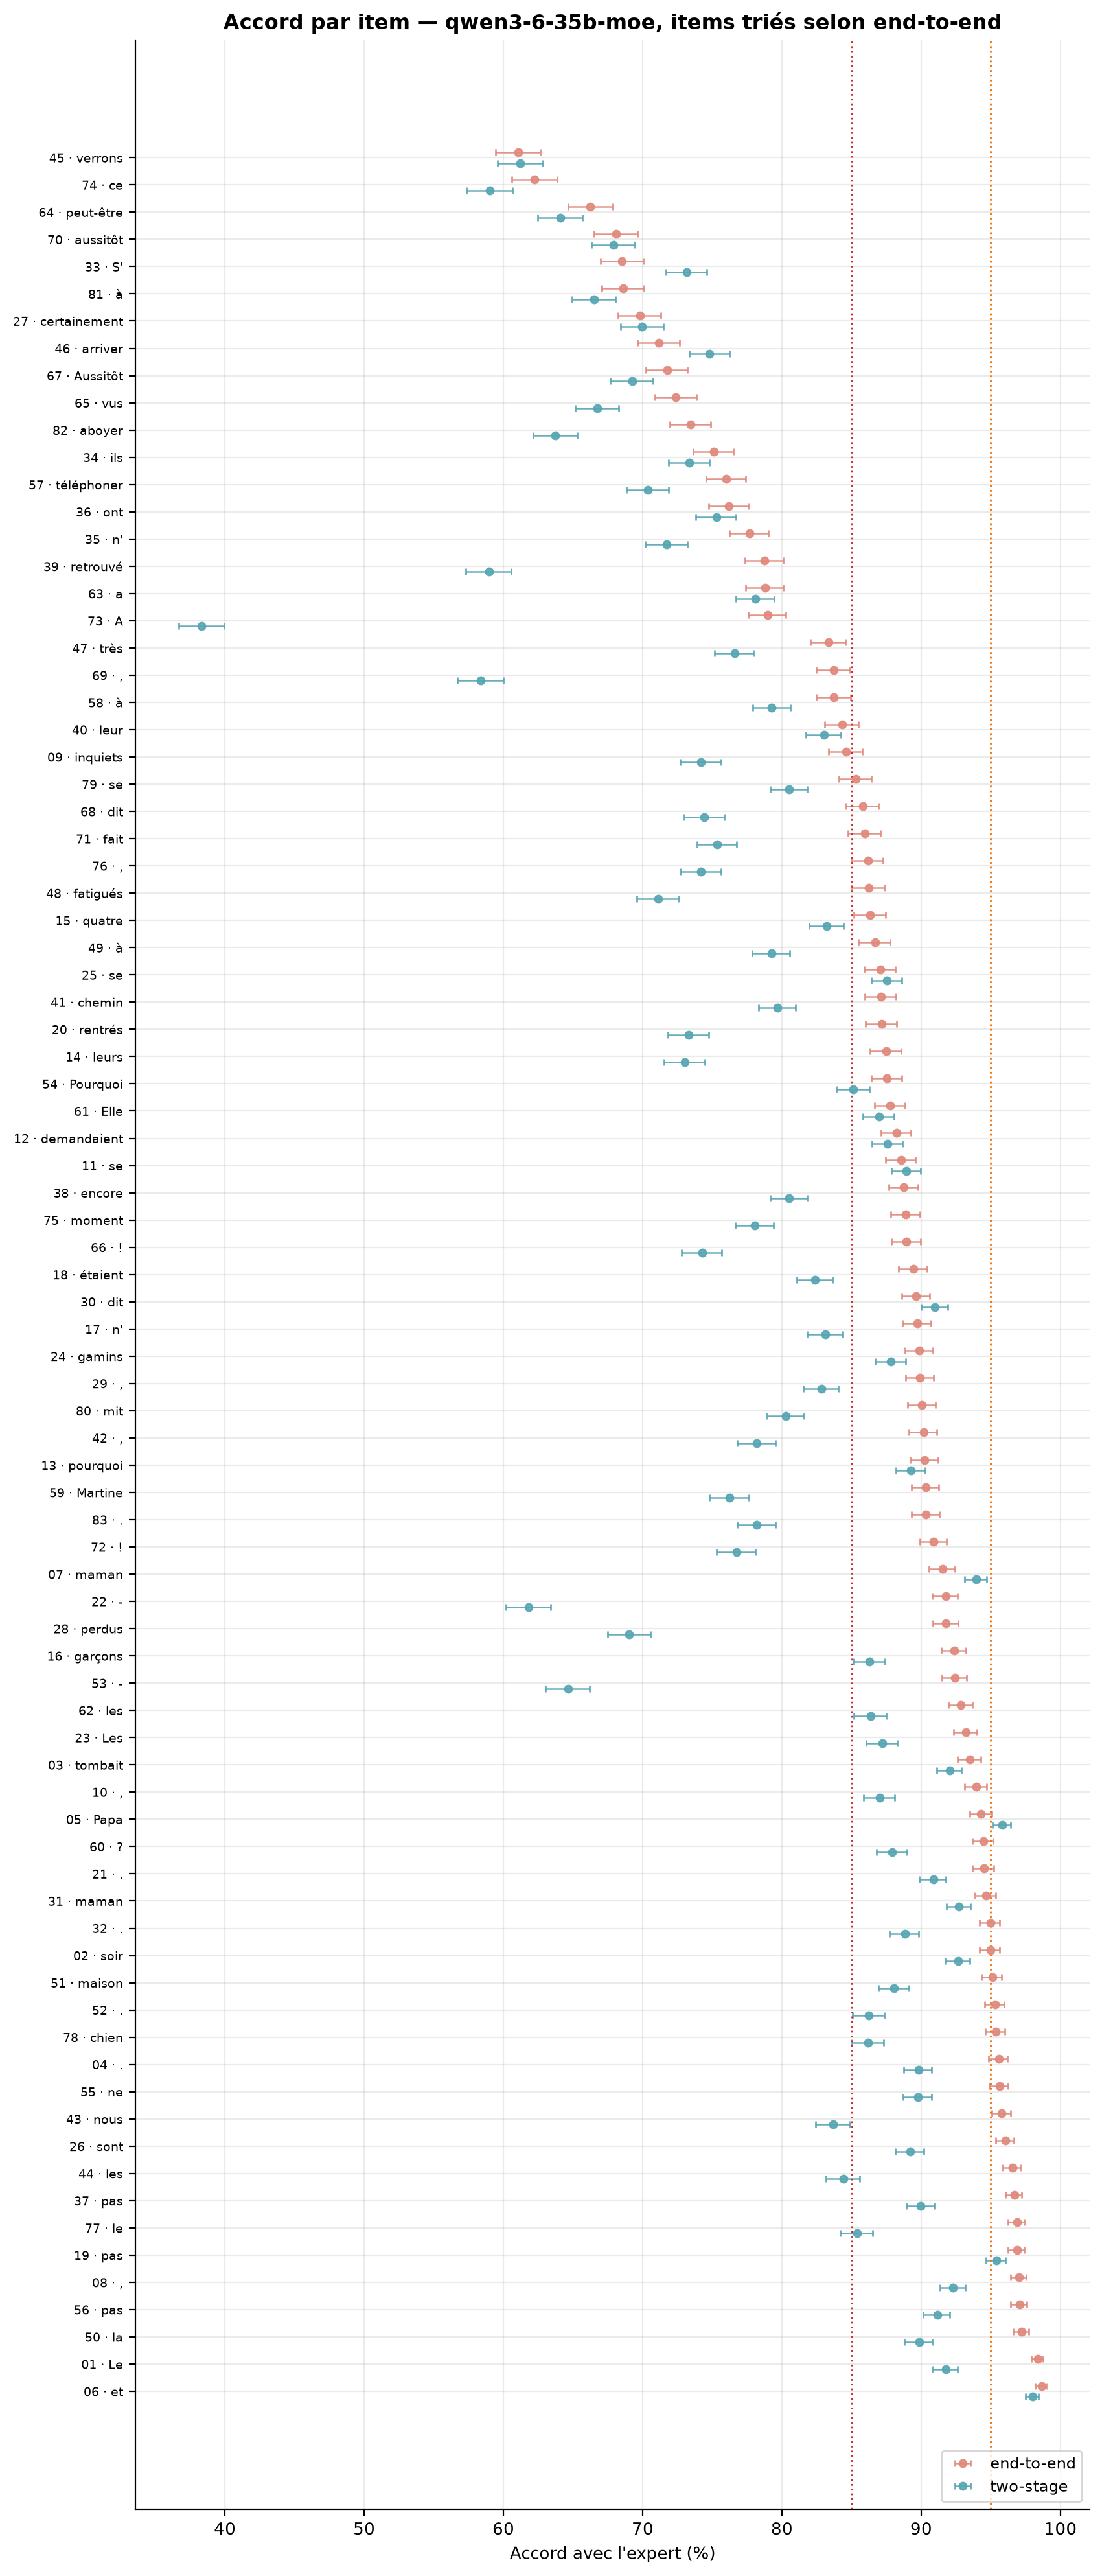
qwen3-6-35b-moe, trié par accord croissant. Barres = IC Wilson 95 %.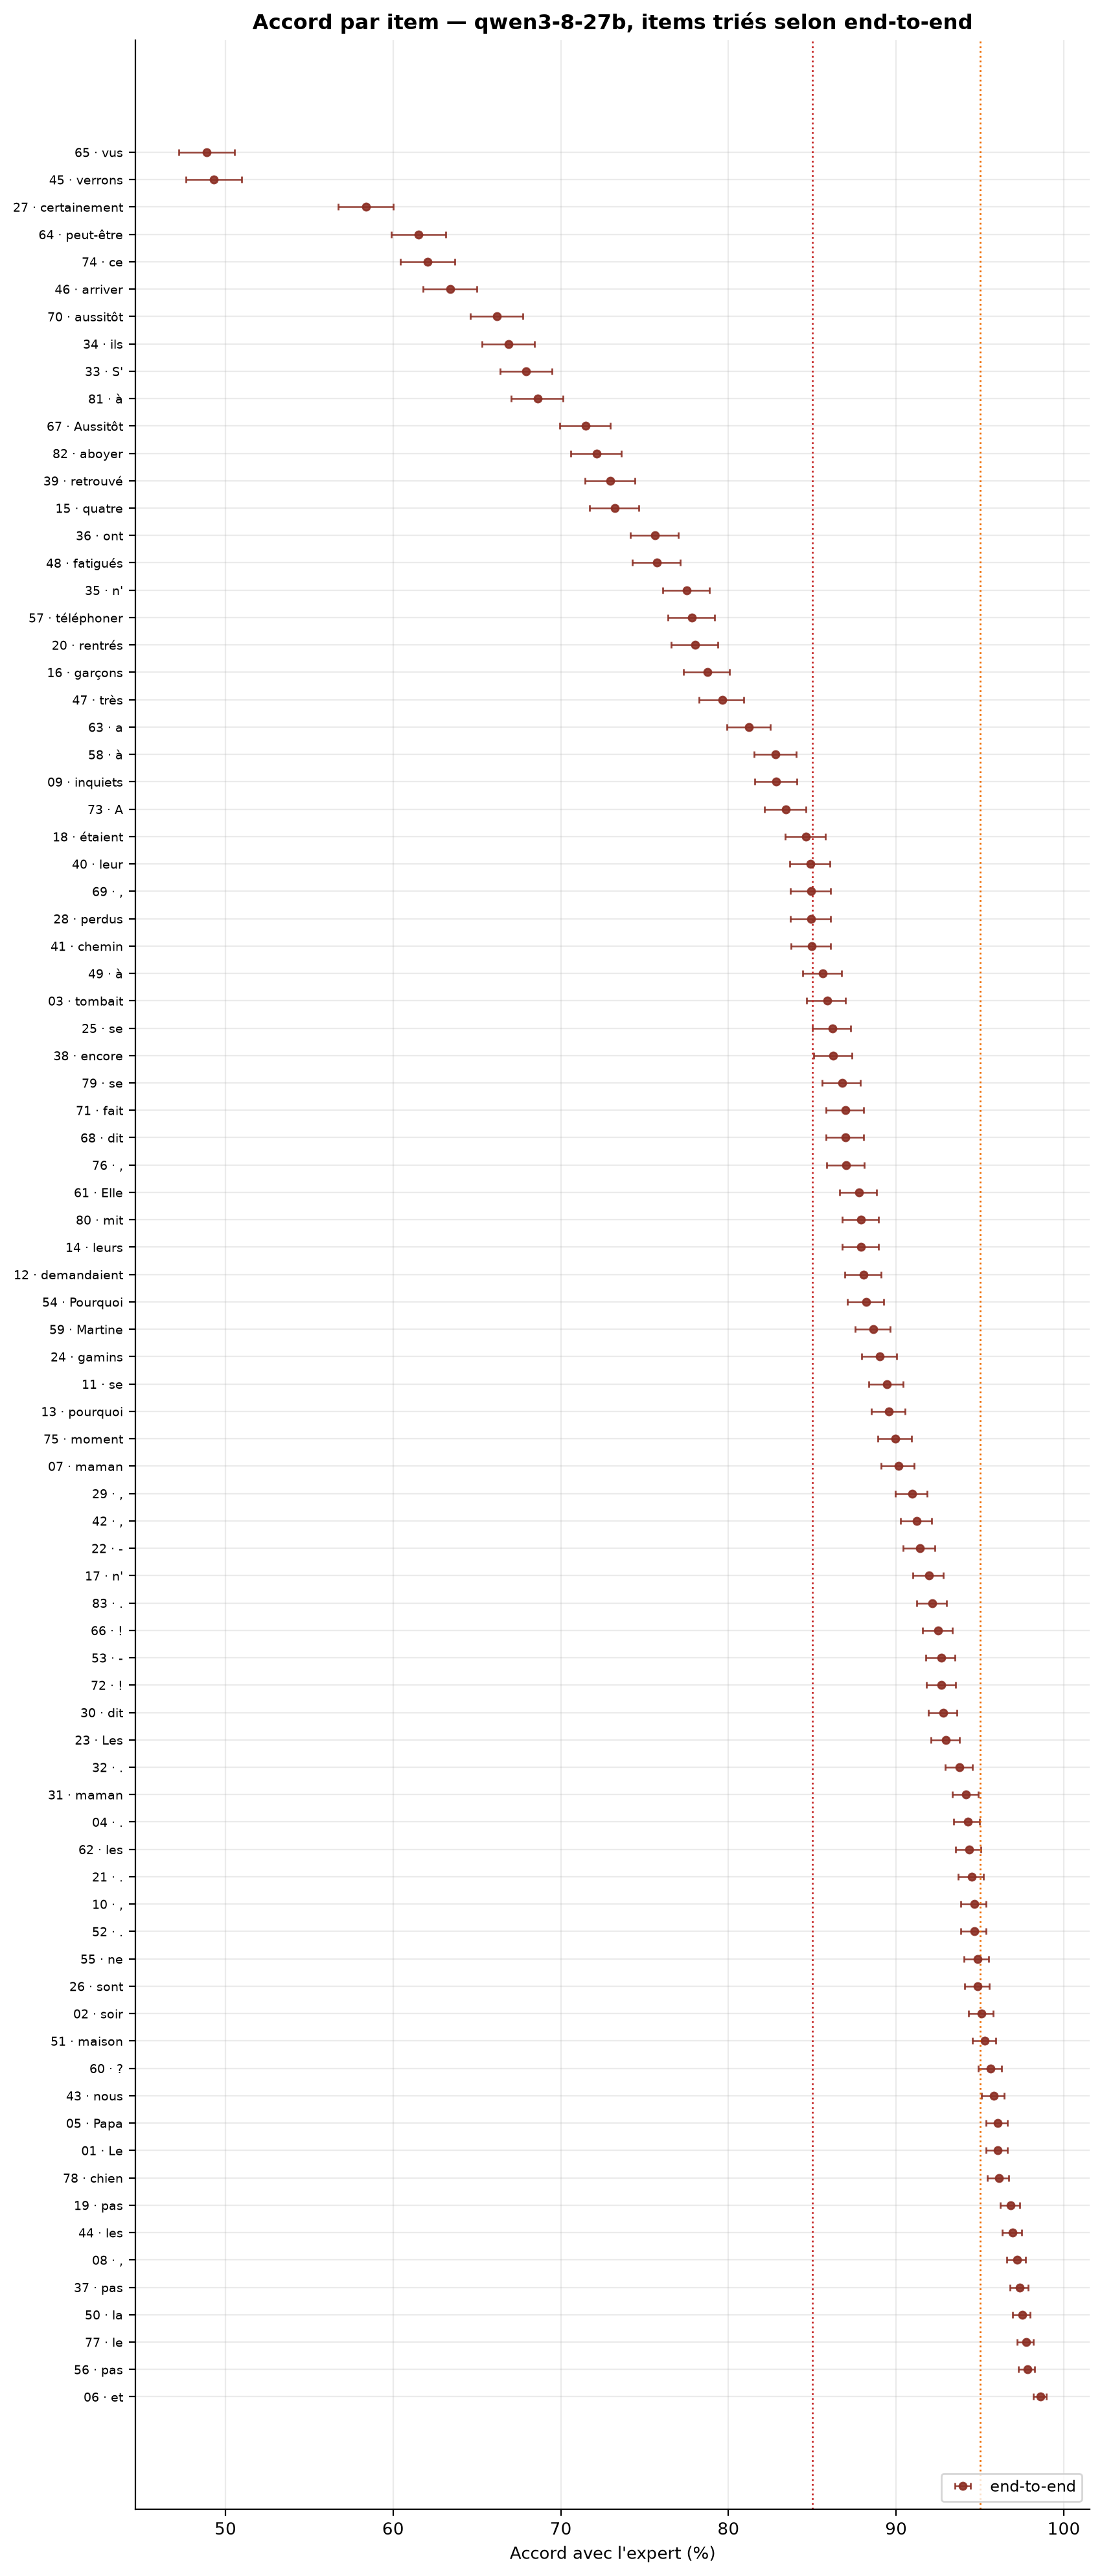
qwen3-8-27b, trié par accord croissant. Barres = IC Wilson 95 %.Accord par copie
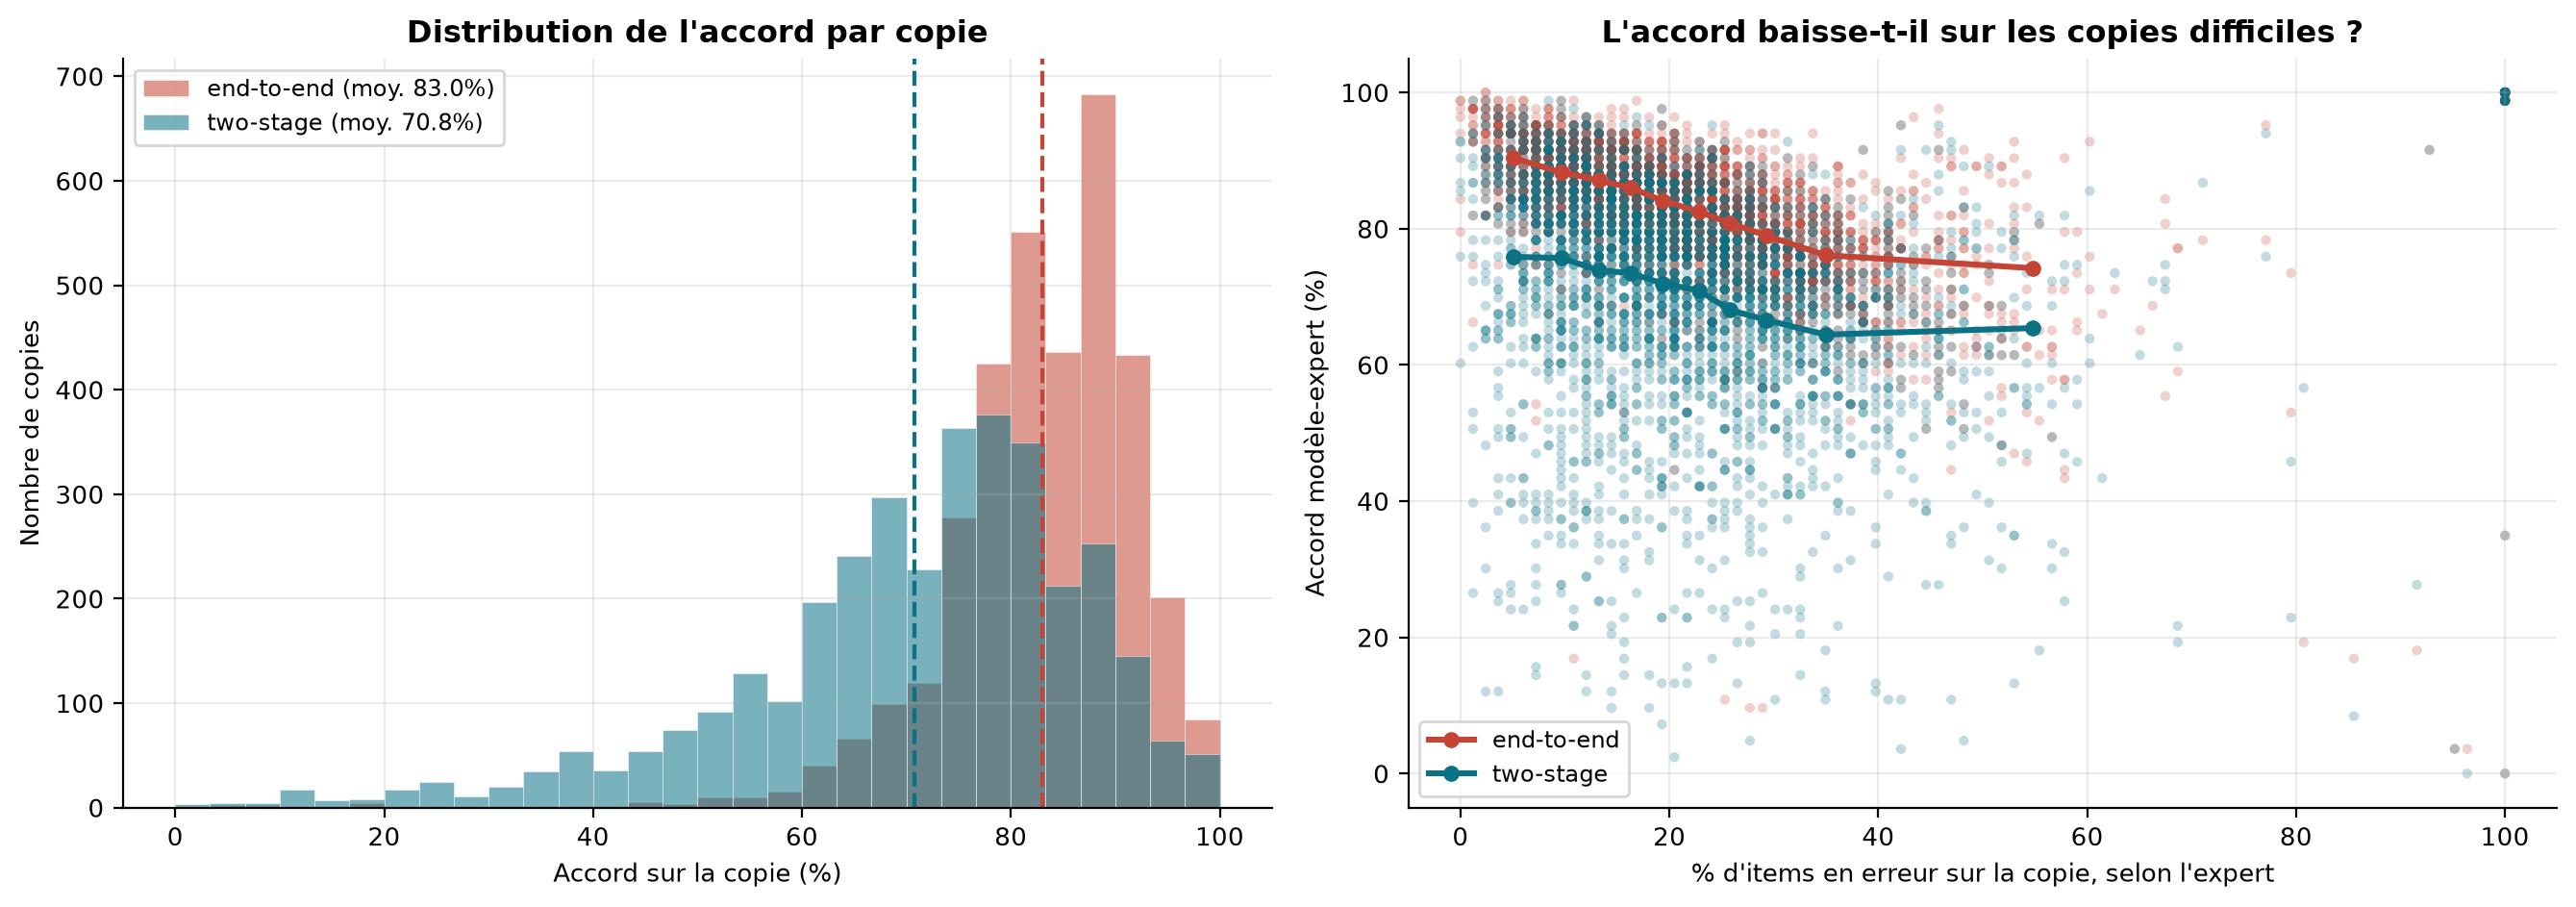
gemma4-26b-moe, et lien entre difficulté de la copie et accord.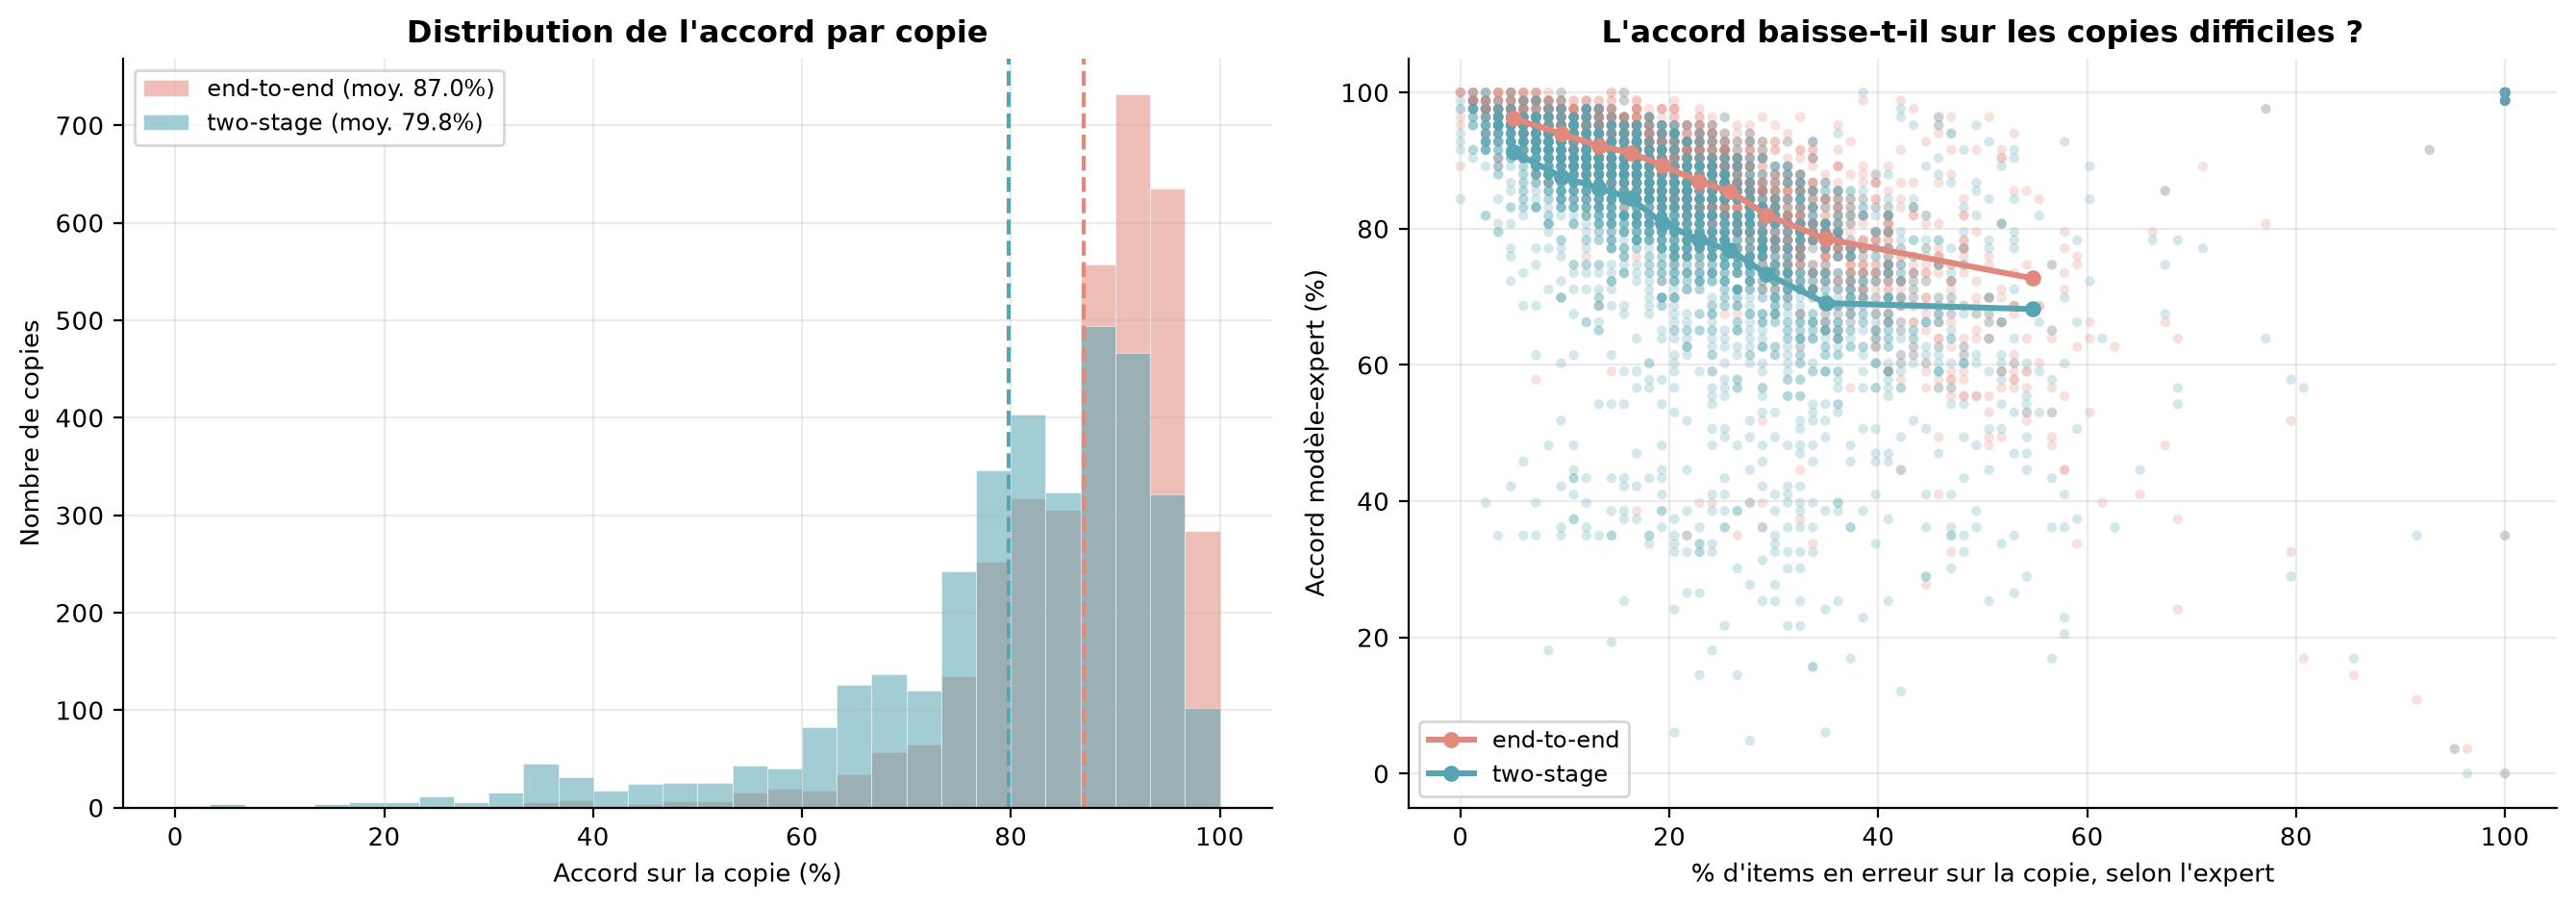
qwen3-6-35b-moe, et lien entre difficulté de la copie et accord.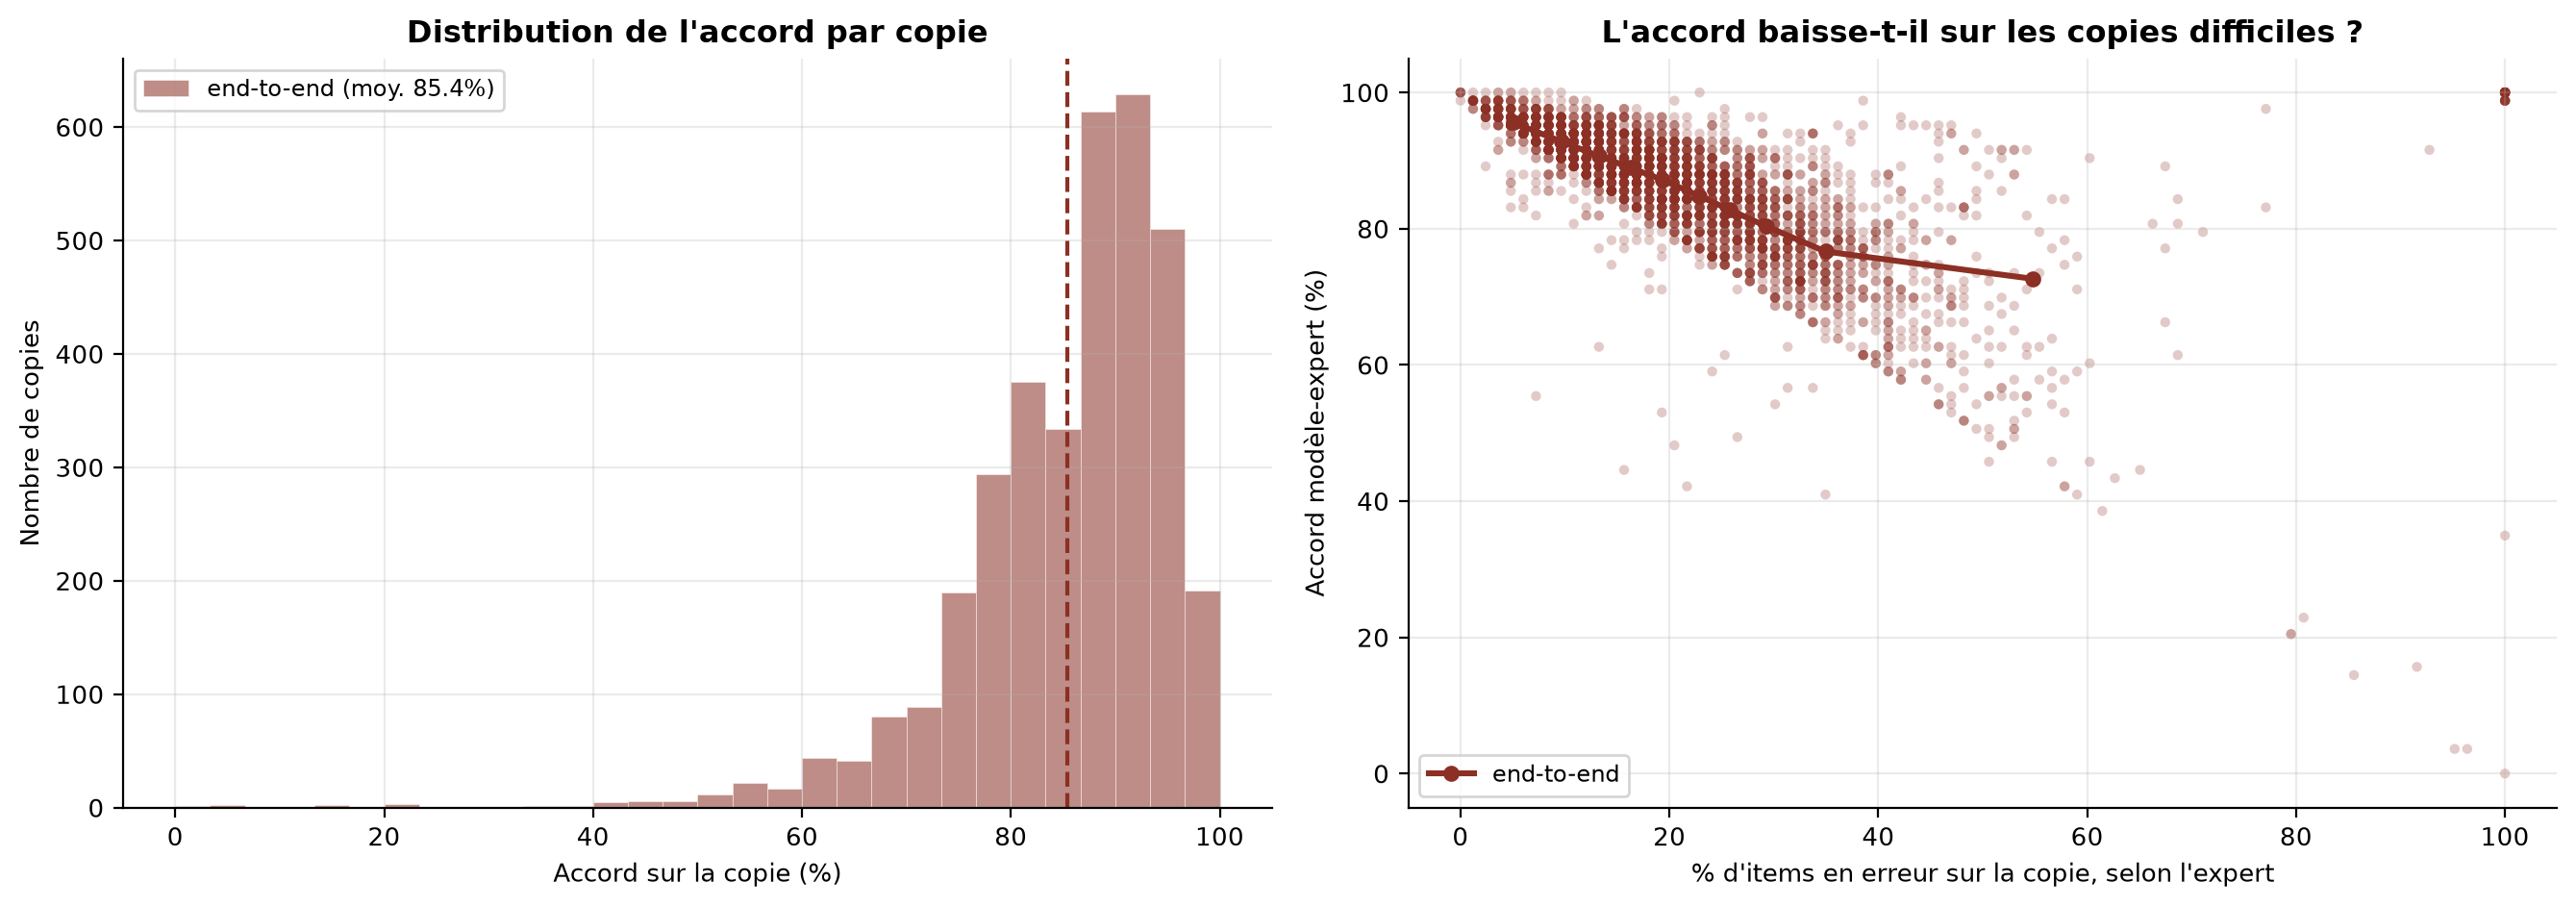
qwen3-8-27b, et lien entre difficulté de la copie et accord.Les copies sur lesquelles le modèle s’écarte le plus de l’expert sont détaillées une par une — statistiques, transcription et codages comparés — dans la page « Écarts IA – humain ». Elle porte sur des productions écrites de mineurs et n’est donc pas publiée : la rendre depuis le SSP Cloud, en retirant l’exclusion de ecarts.qmd dans website/_quarto.yml.
Comparaison de deux modèles
Question : quel modèle code le mieux ? Y répondre exige de comparer les modèles sur les mêmes copies. Sinon l’écart mesuré mélange deux choses : la qualité du modèle, et la composition de l’échantillon que chaque run a traité — et cette composition n’est pas neutre, puisque les copies manquantes sont en général les plus difficiles (échec de transcription) ou simplement les dernières de la file (run inachevé).
Les deux menus ci-dessous choisissent les deux modèles confrontés. Toute cette partie porte sur eux, chacun avec ses deux approches : les métriques sont recalculées sur l’intersection des copies traitées par les runs comparés.
Les deux menus désignent le même modèle : choisir deux modèles différents pour afficher la comparaison. La comparaison des deux approches d’un seul modèle est dans la partie Un modèle à la fois.
Métriques à corpus commun
Quand les runs ne couvrent pas le même corpus, les métriques sont recalculées sur l’intersection des copies traitées ; quand ils le couvrent — le cas dès que tous les runs sont allés au bout —, la synthèse par modèle est déjà comparable telle quelle et n’est pas répétée ici.
Les 4 runs comparés portent tous sur les mêmes 3 422 copies : aucune restriction n’est nécessaire, et les tableaux de la partie Un modèle à la fois sont directement comparables entre modèles. Le classement ci-dessous en découle.
Les 3 runs comparés portent tous sur les mêmes 3 422 copies : aucune restriction n’est nécessaire, et les tableaux de la partie Un modèle à la fois sont directement comparables entre modèles. Le classement ci-dessous en découle.
Les 3 runs comparés portent tous sur les mêmes 3 422 copies : aucune restriction n’est nécessaire, et les tableaux de la partie Un modèle à la fois sont directement comparables entre modèles. Le classement ci-dessous en découle.
Classement des modèles, à approche fixée
Le kappa est retenu comme critère parce qu’il corrige l’accord du hasard, contrairement à l’accord brut que la prévalence gonfle.
| Approche | Kappa par modèle | Meilleur modèle | Écart |
|---|---|---|---|
| end-to-end | qwen3-6-35b-moe 0.564 · gemma4-26b-moe 0.496 |
qwen3-6-35b-moe |
+0.068 |
| two-stage | qwen3-6-35b-moe 0.452 · gemma4-26b-moe 0.367 |
qwen3-6-35b-moe |
+0.085 |
Un écart de kappa n’est concluant que s’il dépasse la largeur des intervalles de confiance du tableau ci-dessus : les lire avant de trancher.
| Approche | Kappa par modèle | Meilleur modèle | Écart |
|---|---|---|---|
| end-to-end | gemma4-26b-moe 0.496 · qwen3-8-27b 0.488 |
gemma4-26b-moe |
+0.008 |
Un écart de kappa n’est concluant que s’il dépasse la largeur des intervalles de confiance du tableau ci-dessus : les lire avant de trancher.
| Approche | Kappa par modèle | Meilleur modèle | Écart |
|---|---|---|---|
| end-to-end | qwen3-6-35b-moe 0.564 · qwen3-8-27b 0.488 |
qwen3-6-35b-moe |
+0.076 |
Un écart de kappa n’est concluant que s’il dépasse la largeur des intervalles de confiance du tableau ci-dessus : les lire avant de trancher.
Consensus inter-modèles
Motivation : quand plusieurs runs indépendants convergent, la prédiction est fiable ; quand ils divergent, c’est un signal d’incertitude qui appelle un humain. Le désaccord inter-modèles est un bien meilleur prédicteur de confiance que le score annoncé par un modèle unique, qui ne varie presque pas — voir score de consensus inter-modèles pour sa définition.
Le consensus est calculé sur les runs des deux modèles choisis, approches confondues, c’est-à-dire sur les items qui leur sont communs. Croiser deux modèles ET deux approches donne un signal plus riche qu’un seul de ces axes : deux architectures différentes servies par deux modèles différents se trompent moins souvent de la même façon.
Sur les 283 829 items communs aux 4 runs de gemma4-26b-moe et qwen3-6-35b-moe, 55.8 % font l’objet d’un accord entre les runs. Le score de confiance moyen par copie (part d’items sur lesquels les modèles s’accordent) vaut 55.8 %.
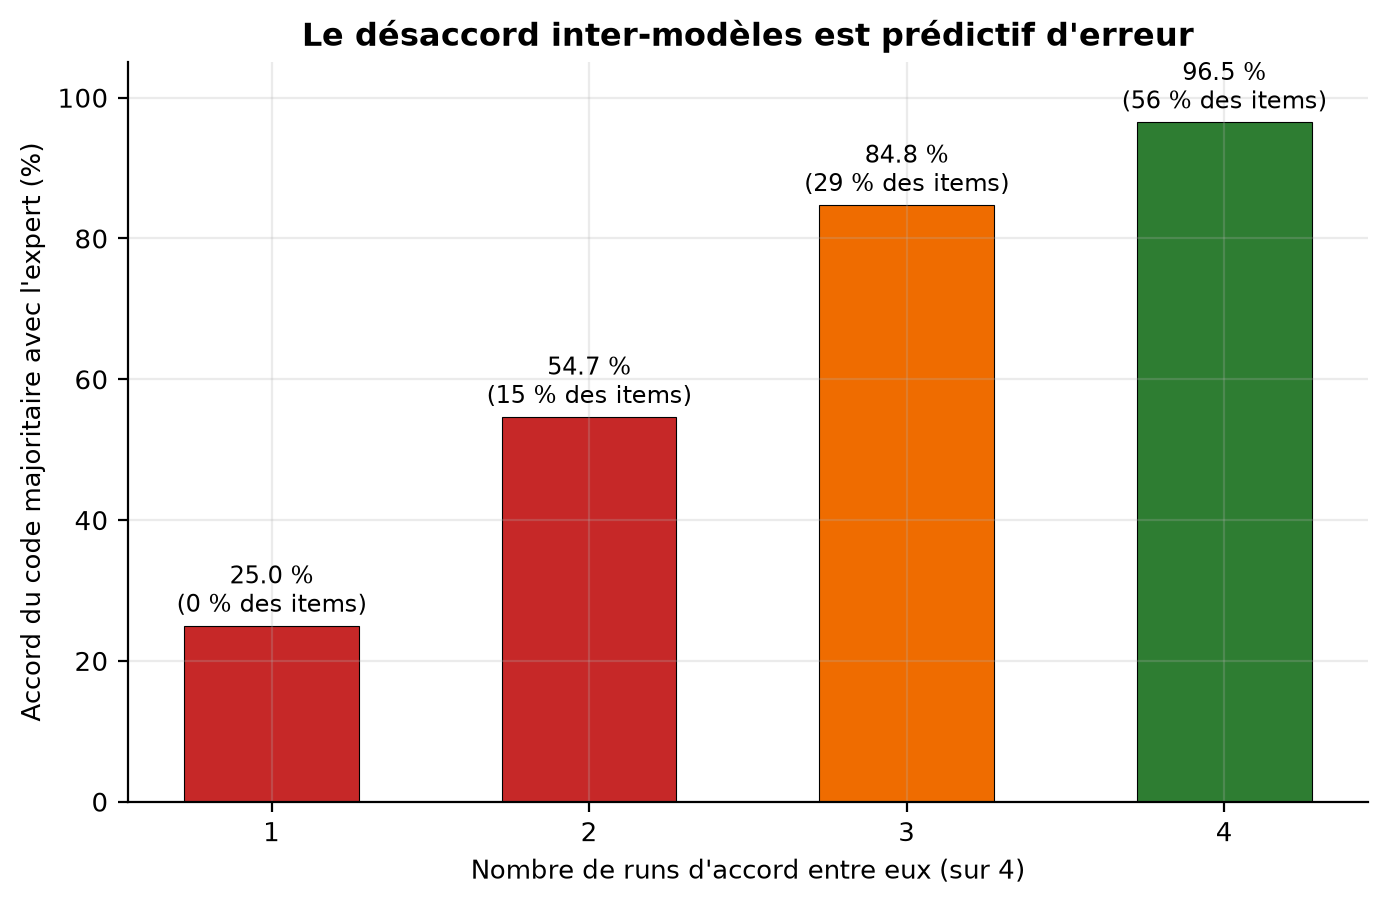
gemma4-26b-moe et qwen3-6-35b-moe prédit l’accord avec l’expert.| Runs d’accord | Items | Part des items | Accord avec l’expert |
|---|---|---|---|
| 1 | 24 | 0.0 % | 25.0 % |
| 2 | 42 256 | 14.9 % | 55.0 % |
| 3 | 83 196 | 29.3 % | 84.9 % |
| 4 | 158 353 | 55.8 % | 96.5 % |
Lecture : quand tous les runs s’accordent (dernière ligne), l’accord avec l’expert est nettement plus élevé. Le désaccord inter-modèles est donc un signal exploitable pour orienter la relecture humaine — c’est ce qu’exploite la section suivante.
Sur les 283 829 items communs aux 3 runs de gemma4-26b-moe et qwen3-8-27b, 61.8 % font l’objet d’un accord entre les runs. Le score de confiance moyen par copie (part d’items sur lesquels les modèles s’accordent) vaut 61.8 %.
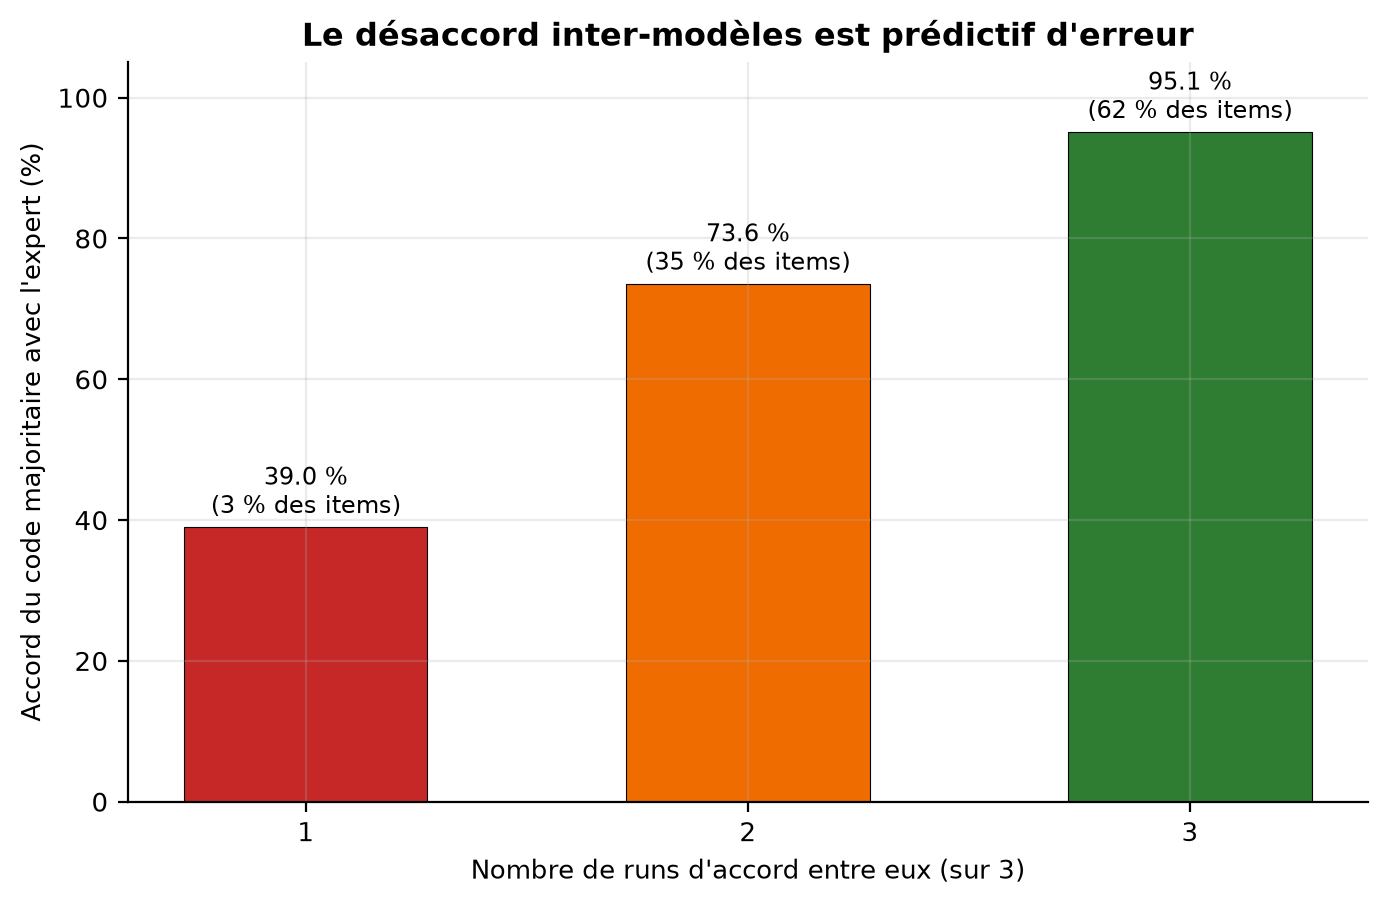
gemma4-26b-moe et qwen3-8-27b prédit l’accord avec l’expert.| Runs d’accord | Items | Part des items | Accord avec l’expert |
|---|---|---|---|
| 1 | 8 000 | 2.8 % | 39.1 % |
| 2 | 100 384 | 35.4 % | 73.8 % |
| 3 | 175 445 | 61.8 % | 95.2 % |
Lecture : quand tous les runs s’accordent (dernière ligne), l’accord avec l’expert est nettement plus élevé. Le désaccord inter-modèles est donc un signal exploitable pour orienter la relecture humaine — c’est ce qu’exploite la section suivante.
Sur les 283 829 items communs aux 3 runs de qwen3-6-35b-moe et qwen3-8-27b, 75.7 % font l’objet d’un accord entre les runs. Le score de confiance moyen par copie (part d’items sur lesquels les modèles s’accordent) vaut 75.6 %.
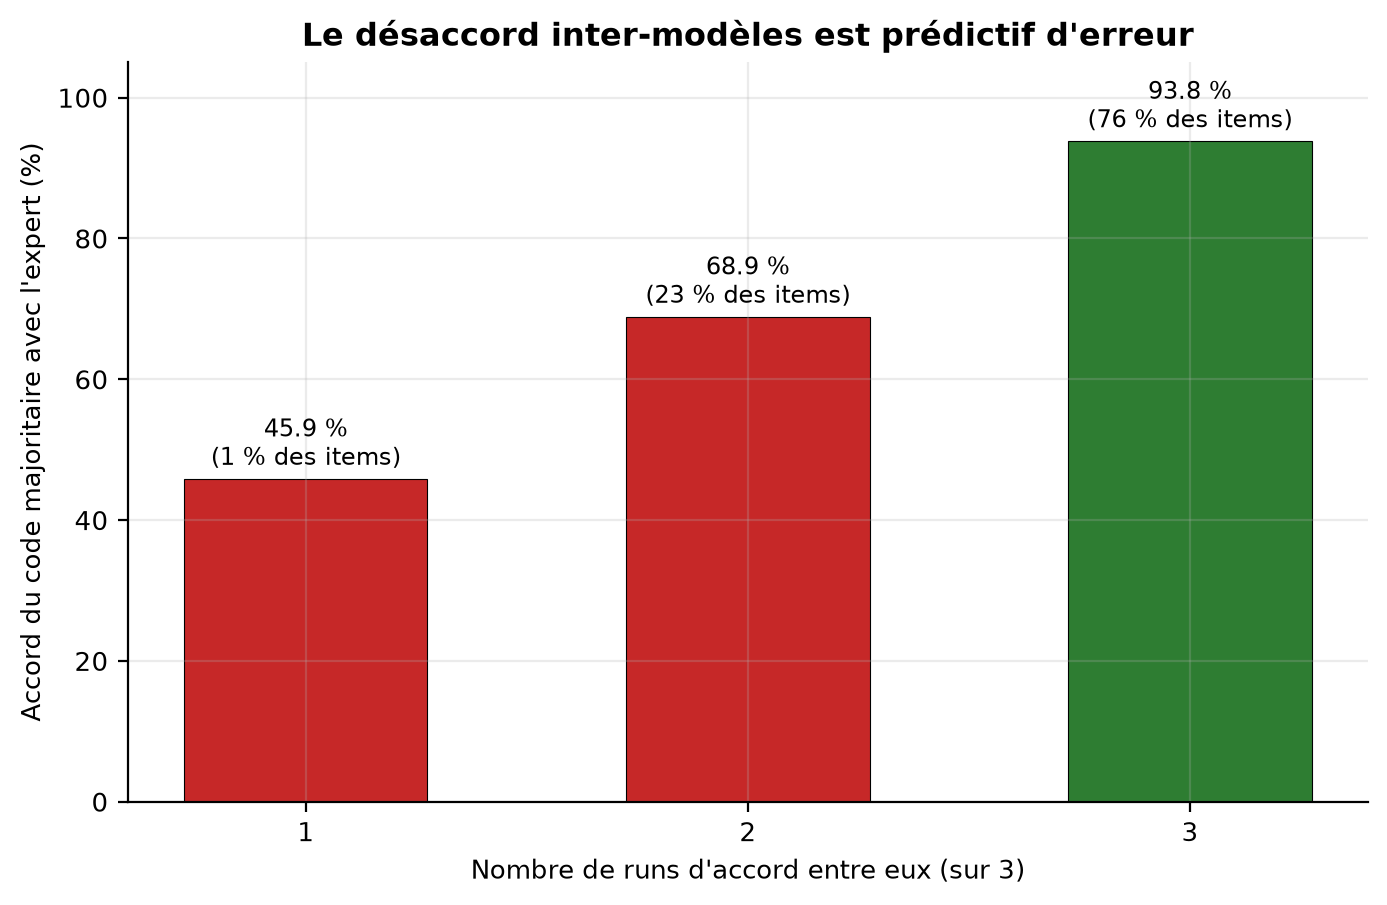
qwen3-6-35b-moe et qwen3-8-27b prédit l’accord avec l’expert.| Runs d’accord | Items | Part des items | Accord avec l’expert |
|---|---|---|---|
| 1 | 2 979 | 1.0 % | 46.1 % |
| 2 | 66 119 | 23.3 % | 69.2 % |
| 3 | 214 731 | 75.7 % | 93.8 % |
Lecture : quand tous les runs s’accordent (dernière ligne), l’accord avec l’expert est nettement plus élevé. Le désaccord inter-modèles est donc un signal exploitable pour orienter la relecture humaine — c’est ce qu’exploite la section suivante.
Stratégie de renvoi vers un correcteur humain
Question opérationnelle : combien de copies faut-il renvoyer en correction humaine pour atteindre un accord cible sur les copies conservées ? On trie les copies par score de confiance et on renvoie celles sous le seuil — la construction de la courbe est détaillée dans courbe de renvoi humain.
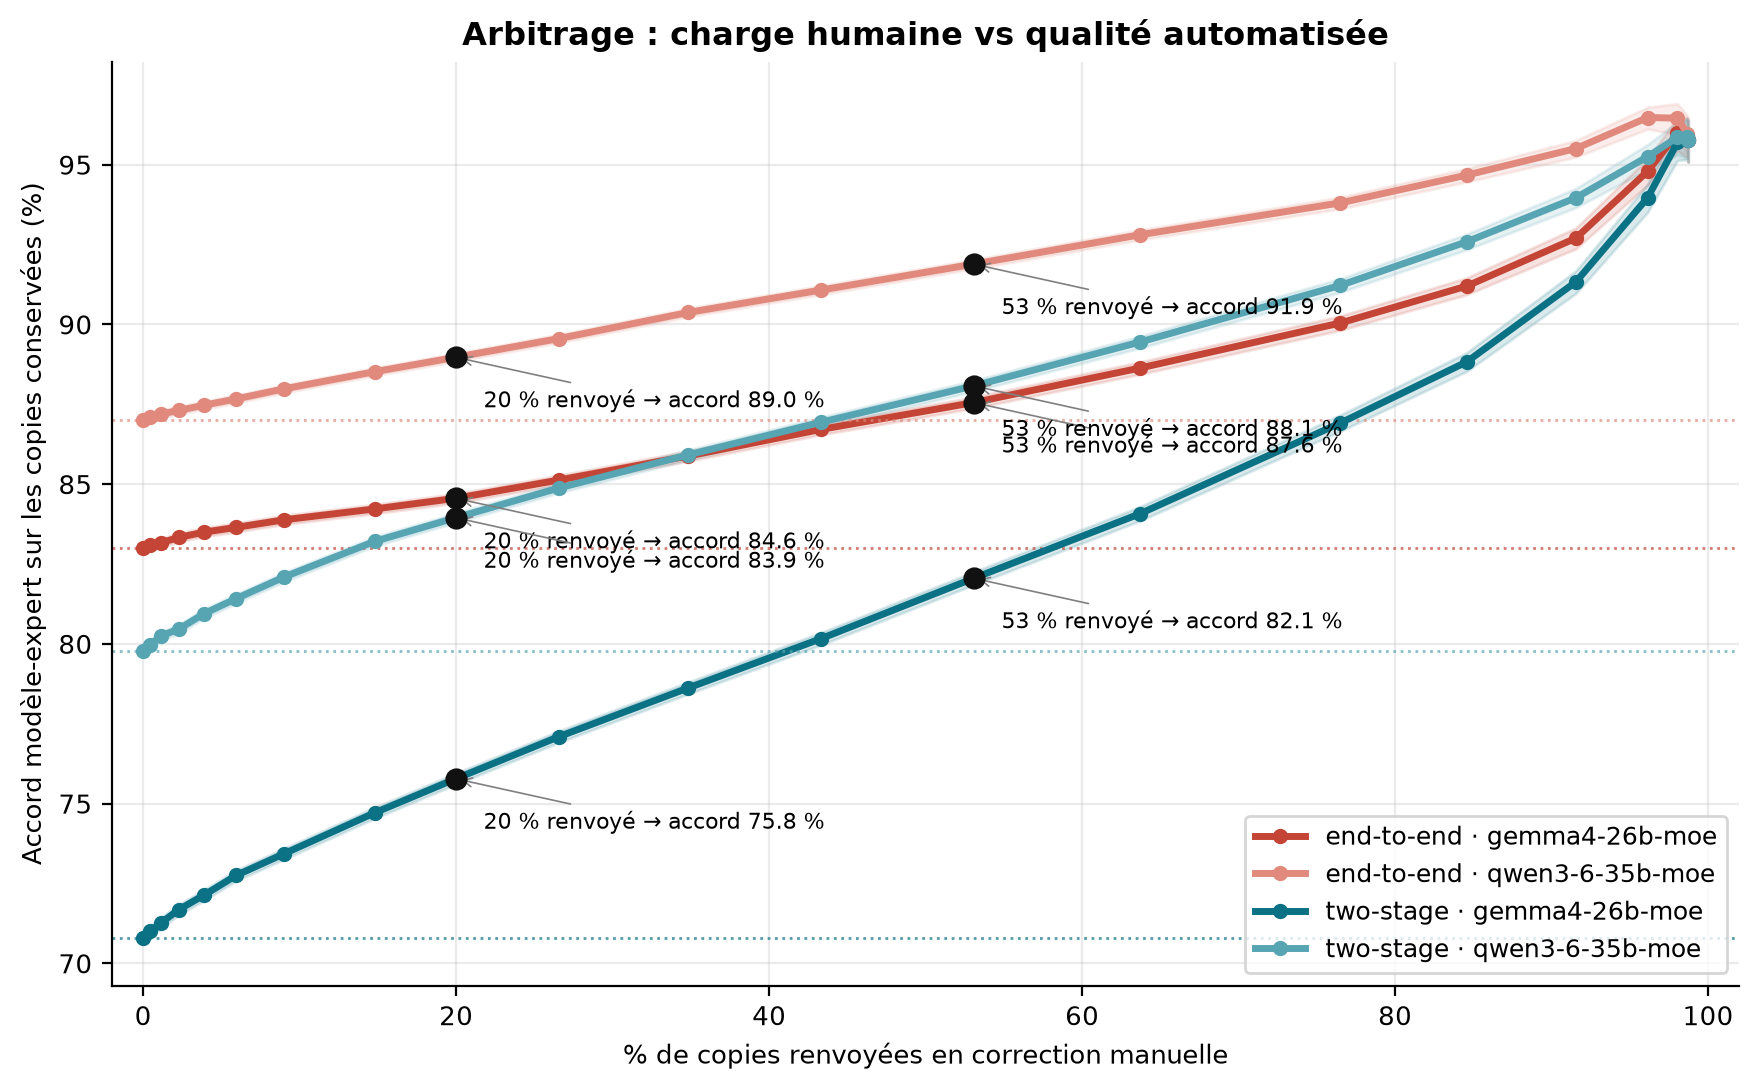
gemma4-26b-moe et qwen3-6-35b-moe.| Seuil de confiance τ | Copies renvoyées | Accord sur les copies conservées | Copies conservées |
|---|---|---|---|
| 50 % | 35.2 % | 85.7 % [85.5 % ; 85.9 %] | 2 219 |
| 60 % | 53.7 % | 87.3 % [87.2 % ; 87.5 %] | 1 585 |
| 70 % | 77.4 % | 89.7 % [89.5 % ; 89.9 %] | 773 |
| 80 % | 92.7 % | 92.2 % [91.8 % ; 92.5 %] | 249 |
| 90 % | 99.3 % | 96.3 % [95.4 % ; 97.1 %] | 24 |
| 95 % | 99.9 % | 98.2 % [94.8 % ; 99.4 %] | 2 |
| 100 % | 100.0 % | — | 0 |
| Seuil de confiance τ | Copies renvoyées | Accord sur les copies conservées | Copies conservées |
|---|---|---|---|
| 50 % | 35.2 % | 90.3 % [90.2 % ; 90.4 %] | 2 219 |
| 60 % | 53.7 % | 91.8 % [91.6 % ; 91.9 %] | 1 585 |
| 70 % | 77.4 % | 93.7 % [93.5 % ; 93.9 %] | 773 |
| 80 % | 92.7 % | 95.5 % [95.2 % ; 95.7 %] | 249 |
| 90 % | 99.3 % | 97.7 % [96.9 % ; 98.3 %] | 24 |
| 95 % | 99.9 % | 100.0 % [97.7 % ; 100.0 %] | 2 |
| 100 % | 100.0 % | — | 0 |
| Seuil de confiance τ | Copies renvoyées | Accord sur les copies conservées | Copies conservées |
|---|---|---|---|
| 50 % | 35.2 % | 78.3 % [78.1 % ; 78.5 %] | 2 219 |
| 60 % | 53.7 % | 81.7 % [81.5 % ; 81.9 %] | 1 585 |
| 70 % | 77.4 % | 86.4 % [86.1 % ; 86.7 %] | 773 |
| 80 % | 92.7 % | 90.5 % [90.1 % ; 90.9 %] | 249 |
| 90 % | 99.3 % | 95.5 % [94.5 % ; 96.4 %] | 24 |
| 95 % | 99.9 % | 97.0 % [93.1 % ; 98.7 %] | 2 |
| 100 % | 100.0 % | — | 0 |
| Seuil de confiance τ | Copies renvoyées | Accord sur les copies conservées | Copies conservées |
|---|---|---|---|
| 50 % | 35.2 % | 85.7 % [85.6 % ; 85.9 %] | 2 219 |
| 60 % | 53.7 % | 87.9 % [87.7 % ; 88.0 %] | 1 585 |
| 70 % | 77.4 % | 91.0 % [90.7 % ; 91.2 %] | 773 |
| 80 % | 92.7 % | 93.6 % [93.3 % ; 94.0 %] | 249 |
| 90 % | 99.3 % | 96.0 % [95.0 % ; 96.8 %] | 24 |
| 95 % | 99.9 % | 97.6 % [94.0 % ; 99.1 %] | 2 |
| 100 % | 100.0 % | — | 0 |
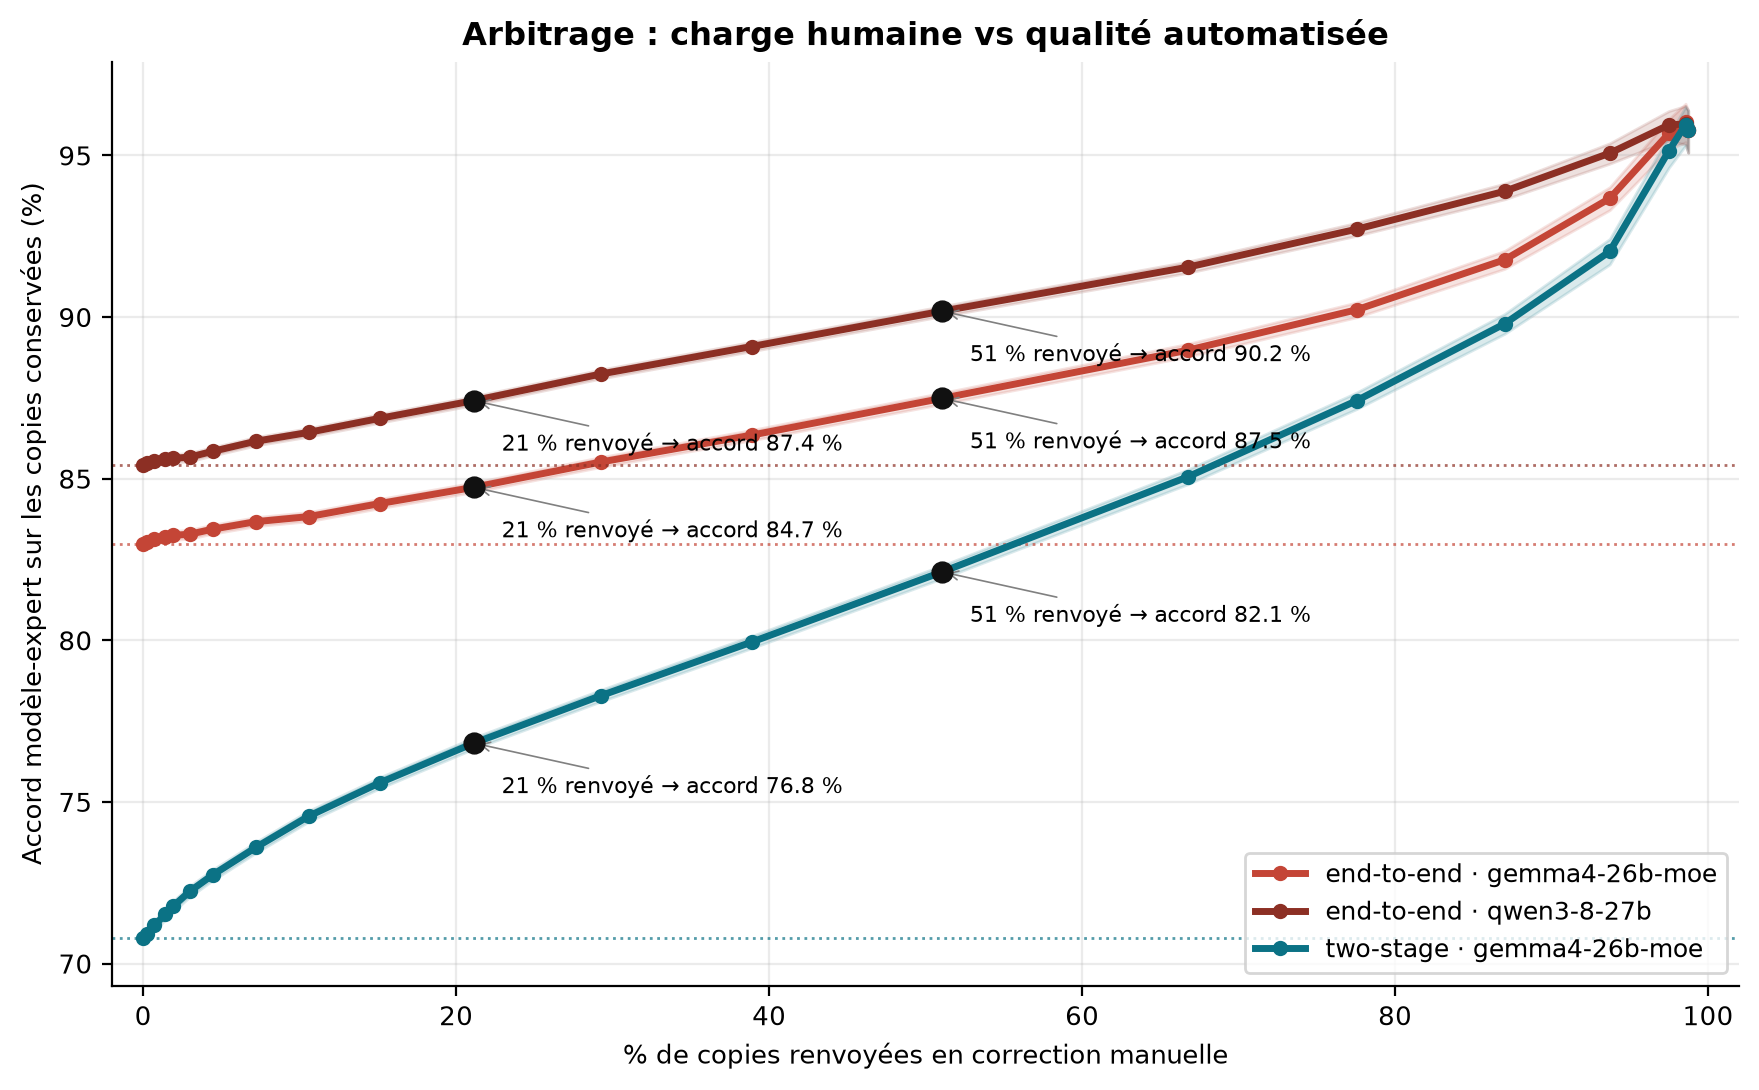
gemma4-26b-moe et qwen3-8-27b.| Seuil de confiance τ | Copies renvoyées | Accord sur les copies conservées | Copies conservées |
|---|---|---|---|
| 50 % | 21.3 % | 84.6 % [84.5 % ; 84.8 %] | 2 692 |
| 60 % | 39.4 % | 86.2 % [86.0 % ; 86.4 %] | 2 074 |
| 70 % | 67.5 % | 88.7 % [88.5 % ; 88.9 %] | 1 112 |
| 80 % | 88.1 % | 91.3 % [91.0 % ; 91.6 %] | 407 |
| 90 % | 98.7 % | 95.6 % [94.8 % ; 96.2 %] | 43 |
| 95 % | 99.8 % | 98.0 % [96.3 % ; 98.9 %] | 6 |
| 100 % | 100.0 % | — | 0 |
| Seuil de confiance τ | Copies renvoyées | Accord sur les copies conservées | Copies conservées |
|---|---|---|---|
| 50 % | 21.3 % | 87.3 % [87.2 % ; 87.5 %] | 2 692 |
| 60 % | 39.4 % | 89.0 % [88.9 % ; 89.2 %] | 2 074 |
| 70 % | 67.5 % | 91.4 % [91.2 % ; 91.5 %] | 1 112 |
| 80 % | 88.1 % | 93.7 % [93.4 % ; 94.0 %] | 407 |
| 90 % | 98.7 % | 96.1 % [95.4 % ; 96.7 %] | 43 |
| 95 % | 99.8 % | 97.4 % [95.6 % ; 98.5 %] | 6 |
| 100 % | 100.0 % | — | 0 |
| Seuil de confiance τ | Copies renvoyées | Accord sur les copies conservées | Copies conservées |
|---|---|---|---|
| 50 % | 21.3 % | 76.6 % [76.4 % ; 76.7 %] | 2 692 |
| 60 % | 39.4 % | 79.7 % [79.5 % ; 79.9 %] | 2 074 |
| 70 % | 67.5 % | 84.6 % [84.4 % ; 84.9 %] | 1 112 |
| 80 % | 88.1 % | 89.2 % [88.8 % ; 89.5 %] | 407 |
| 90 % | 98.7 % | 94.5 % [93.7 % ; 95.2 %] | 43 |
| 95 % | 99.8 % | 97.2 % [95.3 % ; 98.3 %] | 6 |
| 100 % | 100.0 % | — | 0 |
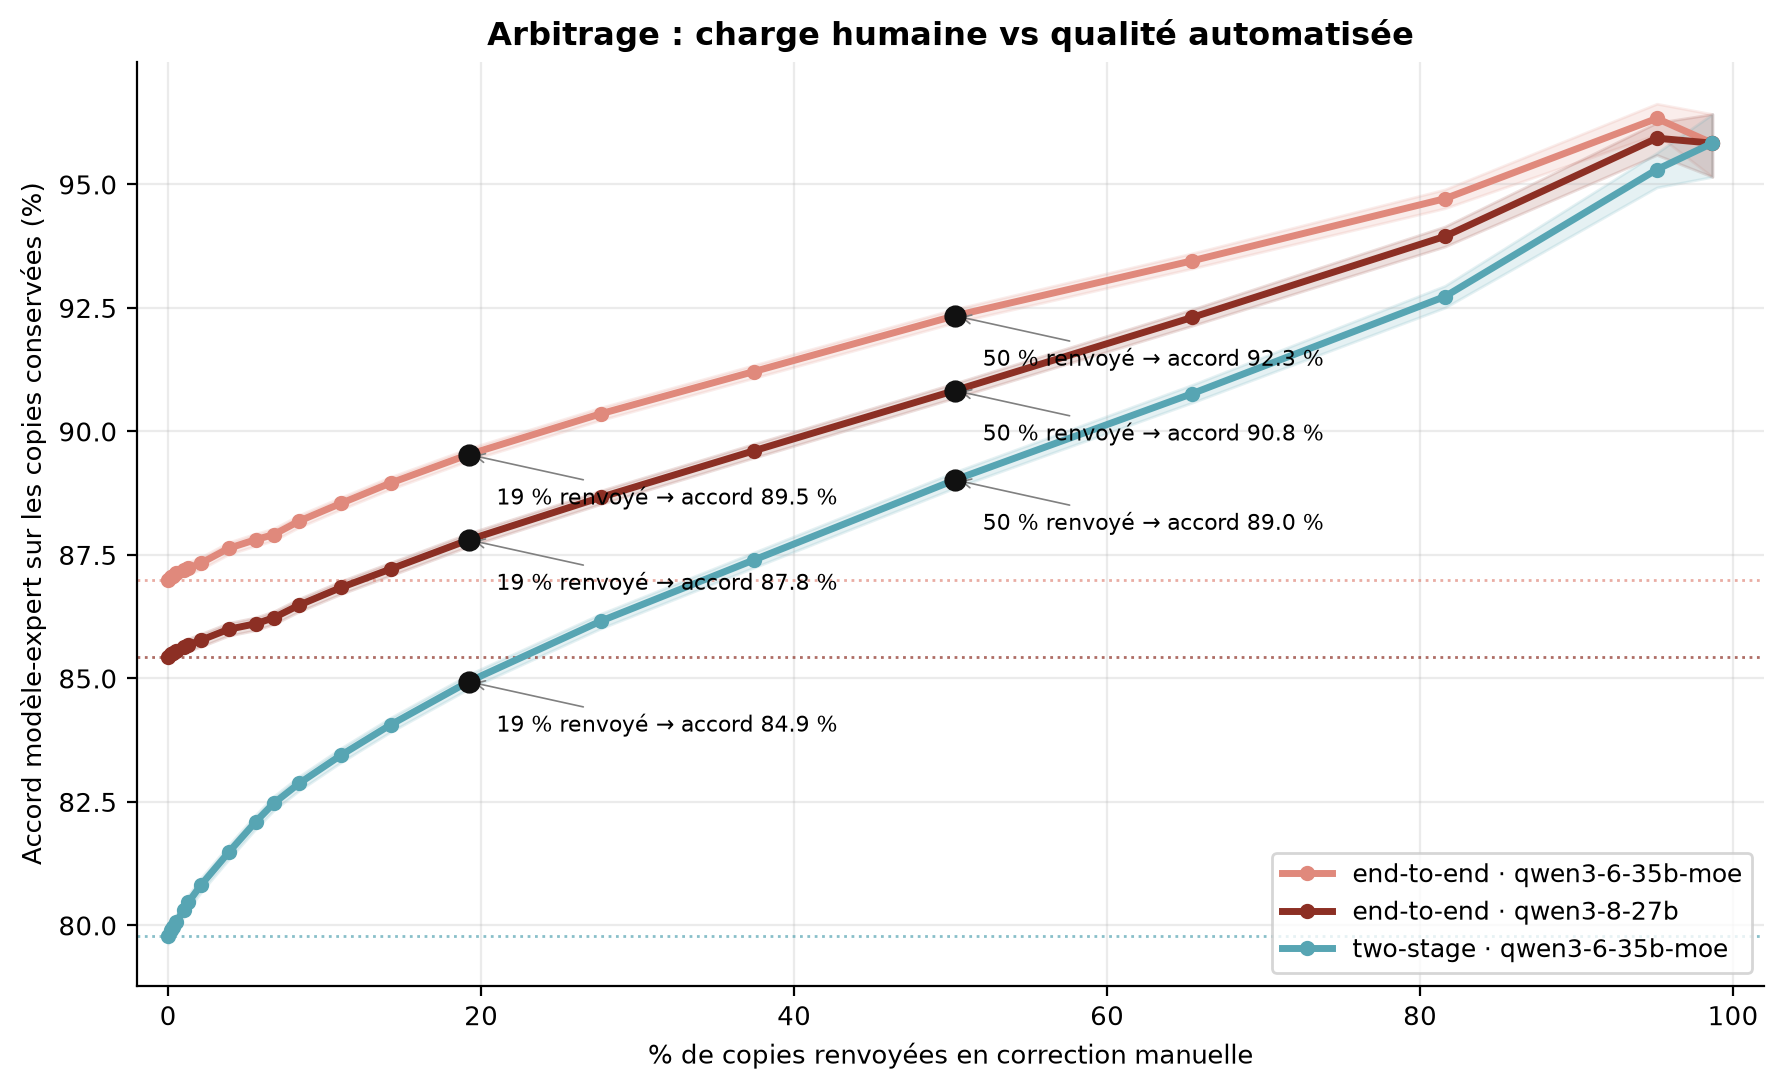
qwen3-6-35b-moe et qwen3-8-27b.| Seuil de confiance τ | Copies renvoyées | Accord sur les copies conservées | Copies conservées |
|---|---|---|---|
| 50 % | 8.3 % | 88.1 % [88.0 % ; 88.2 %] | 3 137 |
| 60 % | 14.3 % | 88.9 % [88.8 % ; 89.0 %] | 2 933 |
| 70 % | 27.9 % | 90.3 % [90.2 % ; 90.4 %] | 2 467 |
| 80 % | 50.8 % | 92.3 % [92.1 % ; 92.4 %] | 1 682 |
| 90 % | 82.6 % | 94.6 % [94.4 % ; 94.8 %] | 595 |
| 95 % | 96.3 % | 96.5 % [96.2 % ; 96.9 %] | 125 |
| 100 % | 99.9 % | 97.0 % [93.1 % ; 98.7 %] | 2 |
| Seuil de confiance τ | Copies renvoyées | Accord sur les copies conservées | Copies conservées |
|---|---|---|---|
| 50 % | 8.3 % | 86.4 % [86.3 % ; 86.5 %] | 3 137 |
| 60 % | 14.3 % | 87.1 % [87.0 % ; 87.2 %] | 2 933 |
| 70 % | 27.9 % | 88.6 % [88.4 % ; 88.7 %] | 2 467 |
| 80 % | 50.8 % | 90.7 % [90.6 % ; 90.9 %] | 1 682 |
| 90 % | 82.6 % | 93.8 % [93.6 % ; 94.0 %] | 595 |
| 95 % | 96.3 % | 96.0 % [95.6 % ; 96.4 %] | 125 |
| 100 % | 99.9 % | 97.0 % [93.1 % ; 98.7 %] | 2 |
| Seuil de confiance τ | Copies renvoyées | Accord sur les copies conservées | Copies conservées |
|---|---|---|---|
| 50 % | 8.3 % | 82.7 % [82.6 % ; 82.9 %] | 3 137 |
| 60 % | 14.3 % | 83.9 % [83.8 % ; 84.1 %] | 2 933 |
| 70 % | 27.9 % | 86.0 % [85.9 % ; 86.2 %] | 2 467 |
| 80 % | 50.8 % | 88.8 % [88.7 % ; 89.0 %] | 1 682 |
| 90 % | 82.6 % | 92.5 % [92.3 % ; 92.7 %] | 595 |
| 95 % | 96.3 % | 95.1 % [94.7 % ; 95.5 %] | 125 |
| 100 % | 99.9 % | 97.0 % [93.1 % ; 98.7 %] | 2 |
Zoom sur la transcription (HTR)
HTR = Handwritten Text Recognition, la reconnaissance d’écriture manuscrite. C’est la brique qui transforme une image en texte. Elle joue un rôle dans l’approche 1 (étape 1), et peut aussi être évaluée seule pour comparer les modèles sur la seule capacité à lire.
Le point délicat, propre à l’écriture d’enfants : on veut une transcription fidèle, c’est-à-dire qui préserve les fautes. Un modèle qui « corrige » spontanément l’orthographe est un mauvais transcripteur ici, même s’il produit un français correct — c’est le biais de sur-correction de lecture, surveillé de près.
L’évaluation de la transcription se fait sur le corpus Scoledit, qui fournit des transcriptions de référence humaines (fautes préservées), du CP au CM2. On mesure la qualité de lecture par le CER et le WER, agrégés en micro-moyenne sur le corpus.
| Modèle | CER | WER | CER normalisé | WER normalisé | Sur-correction |
|---|---|---|---|---|---|
| modèle de base | — | — | — | — | — |
| modèle fine-tuné | — | — | — | — | — |
Le tableau HTR reste vide tant que le benchmark de transcription seule n’a pas été lancé et exporté (RESULTATS_RUN_HTR_BASE, RESULTATS_RUN_HTR_FINETUNE). La colonne sur-correction n’est pas présente dans le JSONL HTR : elle reste à calculer depuis les transcriptions.
- Copies écartées des métriques : 3 copie inexploitable(s), 57 illisible(s), 44 vierge(s) (par run). Une copie vierge est codée « absent » sans appel modèle, et un item illisible (code expert « i ») n’a reçu aucun jugement auquel comparer le modèle : les compter lui imputerait un défaut de numérisation ou d’annotation. Les inclure surestimait le kappa d’environ 0,02. Voir la décision D8.
- Copies écartées des métriques : 3 copie inexploitable(s), 57 illisible(s), 44 vierge(s) (par run). Une copie vierge est codée « absent » sans appel modèle, et un item illisible (code expert « i ») n’a reçu aucun jugement auquel comparer le modèle : les compter lui imputerait un défaut de numérisation ou d’annotation. Les inclure surestimait le kappa d’environ 0,02. Voir la décision D8.
- Non exporté(s), donc absent(s) des comparaisons :
dictee_two_stage_qwen3-8-27b. Lancer le run puisuv run scripts/export_predictions.py --config … --model-name <modèle>. Runs disponibles souss3://projet-production-ecrits-depp/predictions:dictee_end2end_gemma4-26b-moe,dictee_end2end_qwen3-6-35b-moe,dictee_end2end_qwen3-8-27b,dictee_two_stage_gemma4-26b-moe,dictee_two_stage_qwen3-6-35b-moe. - Copies écartées des métriques : 3 copie inexploitable(s), 57 illisible(s), 44 vierge(s) (par run). Une copie vierge est codée « absent » sans appel modèle, et un item illisible (code expert « i ») n’a reçu aucun jugement auquel comparer le modèle : les compter lui imputerait un défaut de numérisation ou d’annotation. Les inclure surestimait le kappa d’environ 0,02. Voir la décision D8.
Comment produire ces chiffres
1. Lancer les runs, puis 2. exporter les prédictions sur S3 — c’est cette exportation que la présente page relit (aucun pipeline n’est réexécuté au rendu) :
3. Rendre le site. Le rendu exige
matplotlibet le noyau Jupyter, réunis dans l’extrawebsite:Ajouter un modèle au menu déroulant
Rien à coder : le nom du modèle fait partie du nom de fichier exporté (
<run>_<modèle>_predictions.jsonl). La page liste les runs présents sousS3_PREDICTIONS_PREFIXet en déduit les modèles à proposer. Exporter un nouveau modèle, réexécuter le rendu, il apparaît dans les deux menus.Un modèle exporté sur une seule approche est proposé quand même, signalé « (1 approche) » dans le menu : sa vue affiche l’approche disponible et dit laquelle manque. Il ne peut pas entrer dans le classement à approche fixée.
Les variables d’environnement ne servent plus qu’à forcer un affichage :
Un modèle demandé mais non exporté est omis, jamais remplacé par un autre : substituer un modèle à un autre fausserait précisément la comparaison que cette page produit. Les runs manquants sont listés dans l’encadré de fin de page, avec l’inventaire de ce qui est réellement exporté.
Le rendu est mis en cache (
execute: freeze: auto) : une page n’est réexécutée que si son.qmdchange. Après un nouvel export de prédictions, forcer le recalcul avecrm -rf website/_freeze, sinon le site réaffiche les chiffres du rendu précédent — et un modèle tout juste exporté n’apparaîtra pas dans les menus.Les figures des vues vivent dans
website/figures/(une par modèle et par section), et le cache ne les régénère pas : supprimer ce dossier sans supprimerwebsite/_freeze/laisserait des images cassées. Les deux se suppriment ensemble.L’exploration interactive (au-delà de ce que le site affiche) se fait dans les notebooks :
notebooks/03_analyse_resultats.ipynb— la source de cette page ;notebooks/04_diagnostic.ipynb— inspection copie par copie, avec image ;notebooks/05_analyse_transcription_htr.ipynb— analyse HTR.Ce qu’on cherche à conclure
Au-delà des chiffres bruts, le projet vise trois décisions :