Documentation pour la maintenance de cartiflette
Cette documentation vise à simplifier l’entrée et la maintenance du projet cartiflette pour des humains, ou des IA.
Elle couvre l’organisation du dépôt, le lancement du pipeline et la façon de vérifier chaque brique quand on le fait évoluer.
| Chapitre | Contenu |
|---|---|
| 01. Les parties du projet | Pipeline de préparation des données, architecture du projet, rôle de chaque module |
| 02. Lancer le pipeline | Différentes manières de lancer le pipeline, pour des tests (en local) ou via l’outil Argo Workflows pour la production |
| 03. Vérifier et faire évoluer | Evocation des tests, de la vérification du pipeline brique par brique, de la procédure à suivre pour un nouveau millésime ou de nouveaux découpages ou formats |
| 04. API GeoJSON | API qui sert le GeoJSON à partir du GeoParquet (non déployée), son coût mesuré et les enjeux de sa mise en production |
| Client Python et sa référence de l’API | Explication des points d’entrée de la librairie disponible pour les utilisateurs et de la démarche pour pousser le paquet sur PyPI |
Il est tout à fait possible de contribuer à cartiflette avec l’appui d’une IA. Des directives pour Claude Code sont dans le fichier claude.md à la racine du projet sur Github.
Une partie du code source de cartiflette a été généré par IA. De même pour cette documentation: elle a néanmoins
Architecture générale
Le projet cartiflette est principalement structuré en deux parties:
- La (dé)construction de sources open data pour en faire des fichiers plus directement utilisables
- Des librairies directement utilisables par les utilisateurs (clients
Python,RouJavascript) pour aller picorer ces fichiers prêts à l’emploi.
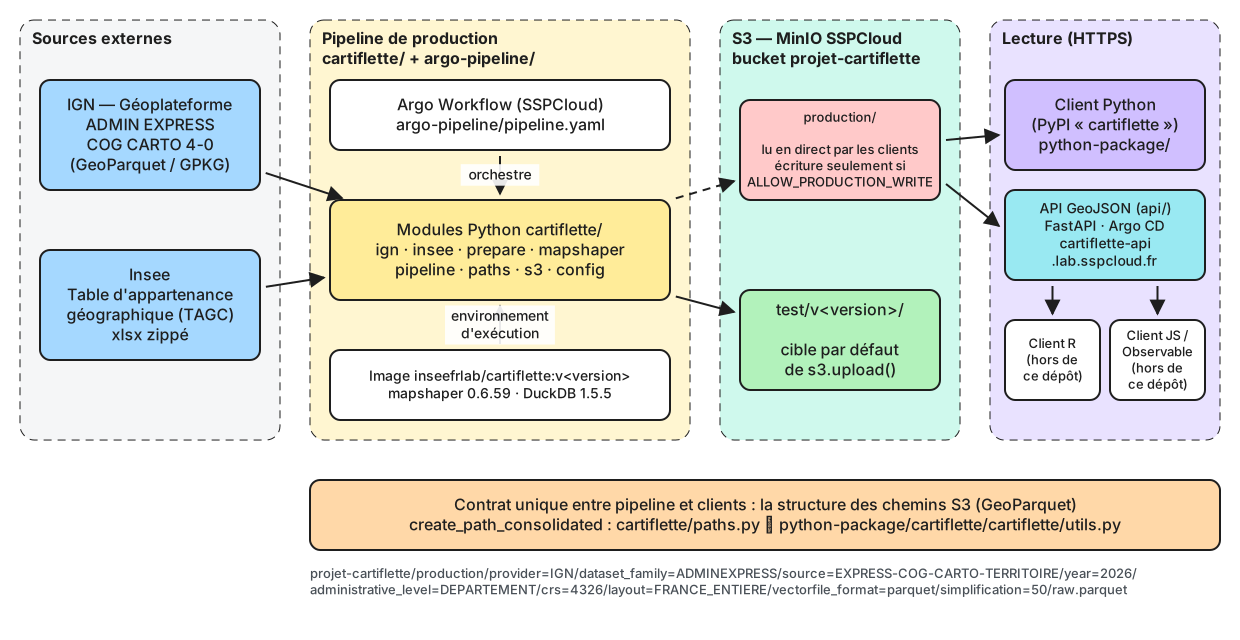
Plus de détails dans la page dédiée à l’architecture du projet.
Les cinq règles à retenir
Ces 5 règles sont principalement à destination d’agents IA mais il ne fait pas de mal d’en avoir conscience aussi en tant qu’humain:
- Ne jamais écrire dans
projet-cartiflette/productionsans l’avoir décidé explicitement : les clients Python, R et JS lisent ce dossier en direct. - Toute écriture S3 passe par
cartiflette/s3.py::upload. Pas defs.put*direct, pas demc. - Les chemins S3 sont le seul contrat entre le pipeline et les clients :
cartiflette/paths.pyetpython-package/cartiflette/cartiflette/utils.py::create_path_bucketdoivent rester identiques. - mapshaper reste en 0.6.59 et DuckDB en 1.5.5 en attendant quelques nug fixes.
- Travailler sur une branche.
mainest la révision qu’Argo clone par défaut.
Autres documents du dépôt
- CLAUDE.md : règles de travail résumées (sécurité S3, style de code, pièges DuckDB) ;
- CONTRIBUTING.md : structure du code et tests, en bref ;
- argo-pipeline/README.md : notes sur le workflow Argo ;
- python-package/cartiflette/README.md : usage du client Python.