Les parties du projet
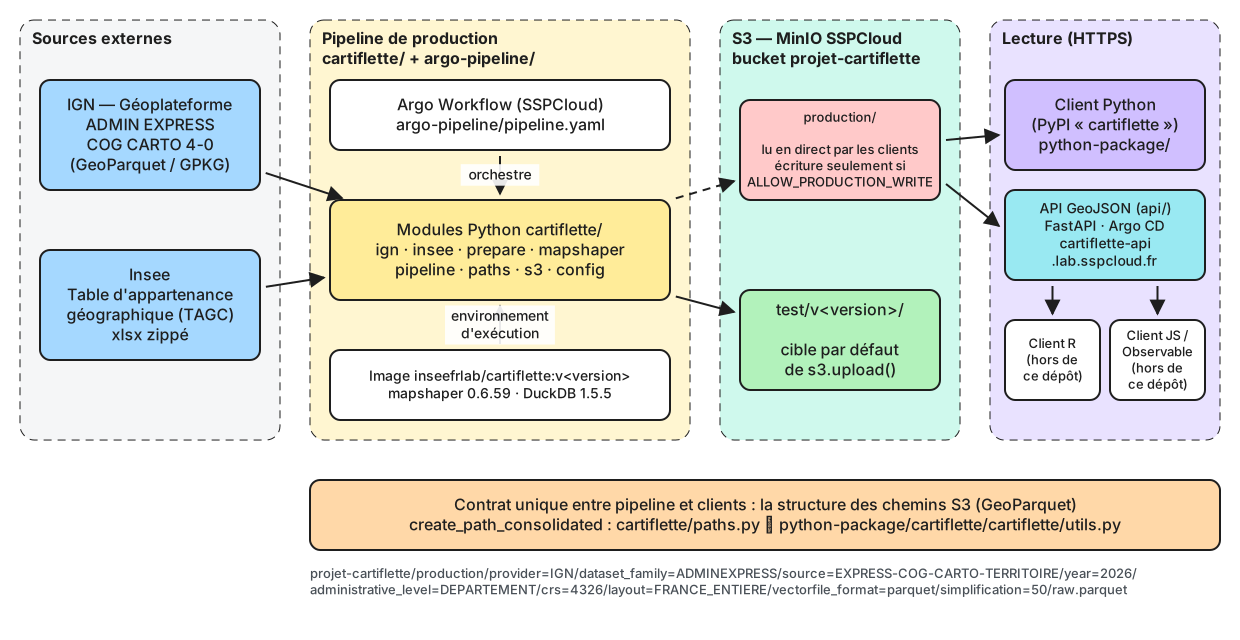
Source Excalidraw : diagrams/architecture.excalidraw
Deux produits dans un même dépôt
| Pipeline de production | Client Python | |
|---|---|---|
| Dossier | cartiflette/ + argo-pipeline/ |
python-package/cartiflette/ |
| Nom de distribution | cartiflette-pipeline (non publié) |
cartiflette sur PyPI |
| Rôle | fabriquer les fonds de carte et les écrire sur S3 | lire ces fichiers en HTTPS et renvoyer un GeoDataFrame |
| Dépendances clés | DuckDB 1.5.5, mapshaper 0.6.59 (Node), s3fs, py7zr | DuckDB (≥ 1.5), geopandas, pyarrow |
pyproject.toml / uv.lock |
à la racine | dans python-package/cartiflette/ |
| Tests | tests/ |
python-package/cartiflette/tests/ |
| Où ça tourne | pods Argo sur le SSPCloud (image Docker) | poste de l’utilisateur |
Les deux produits ne s’importent pas l’un l’autre. Les clients R et JS (Observable) vivent dans d’autres dépôts mais lisent les mêmes fichiers.
Un troisième dossier, api/, contient une API (non déployée) qui sert le GeoJSON à partir du GeoParquet, en s’appuyant sur le client Python : voir 04. API GeoJSON.
Le contrat : la structure des chemins S3
Le seul lien entre le pipeline et tous les clients est l’emplacement des fichiers. Le pipeline ne publie que du GeoParquet, dont le chemin est construit par deux fonctions qui doivent rester identiques :
cartiflette/paths.py::create_path_consolidated(pipeline) ;python-package/cartiflette/cartiflette/utils.py::create_path_consolidated(client).
Les GeoJSON ne sont plus produits : le GeoJSON est servi par l’API (04). Les fichiers déjà publiés (2022) restent lisibles, à l’arborescence ci-dessous, construite par create_path_bucket, qui n’existe plus que dans le client (et que l’API accepte telle quelle) :
{bucket}/{path_within_bucket}
  /provider=IGN
  /dataset_family=ADMINEXPRESS
  /source=EXPRESS-COG-CARTO-TERRITOIRE
  /year={année}
  /administrative_level={niveau des polygones}      ex. DEPARTEMENT
  /crs={EPSG}                                       4326
  /{niveau de découpage}={valeur}                   ex. REGION=11
  /vectorfile_format=geojson
  /territory=metropole
  /simplification={0|50}
  /raw.geojson
Le GeoParquet a une arborescence différente, construite par create_path_consolidated : un seul fichier par niveau, que le client et l’API filtrent à la lecture.
{bucket}/{path_within_bucket}
  /provider=IGN
  /dataset_family=ADMINEXPRESS
  /source=EXPRESS-COG-CARTO-TERRITOIRE
  /year={année}
  /administrative_level={niveau des polygones}      ex. COMMUNE
  /crs={EPSG}                                       4326
  /layout={FRANCE_ENTIERE|FRANCE_ENTIERE_DROM_RAPPROCHES}
  /vectorfile_format=parquet
  /simplification={0|50}
  /raw.parquet
layout=FRANCE_ENTIERE_DROM_RAPPROCHES est à part parce que ses géométries diffèrent (DROM déplacés, zoom sur l’Île-de-France). Dans chaque fichier :
- les lignes sont triées (
pipeline.sort_levels) en groupes de 2 048 lignes, pour que chaque région, département ou zonage tienne dans un ou deux groupes : communes par région, département, bassin de vie puis commune ; départements par région puis département ; zonages par territoire puis code ; - une colonne
bboxest déclarée comme covering GeoParquet 1.1, pour filtrer par emprise ; - la métadonnée
cartiflette:filter_columnsassocie chaquefilter_byutilisable à sa colonne (ex.BASSIN_VIE→BV2022). Elle fait partie du contrat avec les clients.
Certaines valeurs sont figées uniquement pour que les clients continuent de fonctionner (voir cartiflette/config.py) :
source=EXPRESS-COG-CARTO-TERRITOIRE, alors que la source réelle est ADMIN EXPRESS COG CARTO « France entière » ;territory=metropolepour tous les fichiers, DROM compris ;filename=raw.
Les deux suites de tests fixent la même chaîne attendue (tests/test_paths_and_s3.py et python-package/cartiflette/tests/test_client.py). Si l’une change, les clients ne trouvent plus les fichiers.
Côté client, deux ajustements se font sans toucher au contrat : value_candidates essaie REGION=01 puis REGION=1 (codes non complétés avant 2025) et standardize_format accepte geoparquet comme alias de parquet.
Le stockage S3
MinIO du SSPCloud (https://minio.lab.sspcloud.fr), bucket projet-cartiflette :
| Préfixe | Qui écrit | Qui lit |
|---|---|---|
production/ |
le pipeline, uniquement avec CARTIFLETTE_ALLOW_PRODUCTION_WRITE=true |
tous les clients, en direct (HTTPS public) |
test/v<version>/ |
le pipeline, par défaut | vous, pour vérifier |
test/ (racine) |
personne : contient d’anciens essais, ne pas écrire à sa racine | — |
En production : 2023 à 2026 en GeoParquet (pipeline 0.3.0, publiés le 4 octobre 2026), 2022 en GeoJSON seulement (ancien pipeline). 2021 n’y a qu’un fichier intermédiaire (preprocessed=before_cog) que les clients ne lisent pas. Le code actuel sait produire 2022 à 2024 à partir des éditions 3-x (shapefile), voir l’étape 1.
Le pipeline de production, module par module
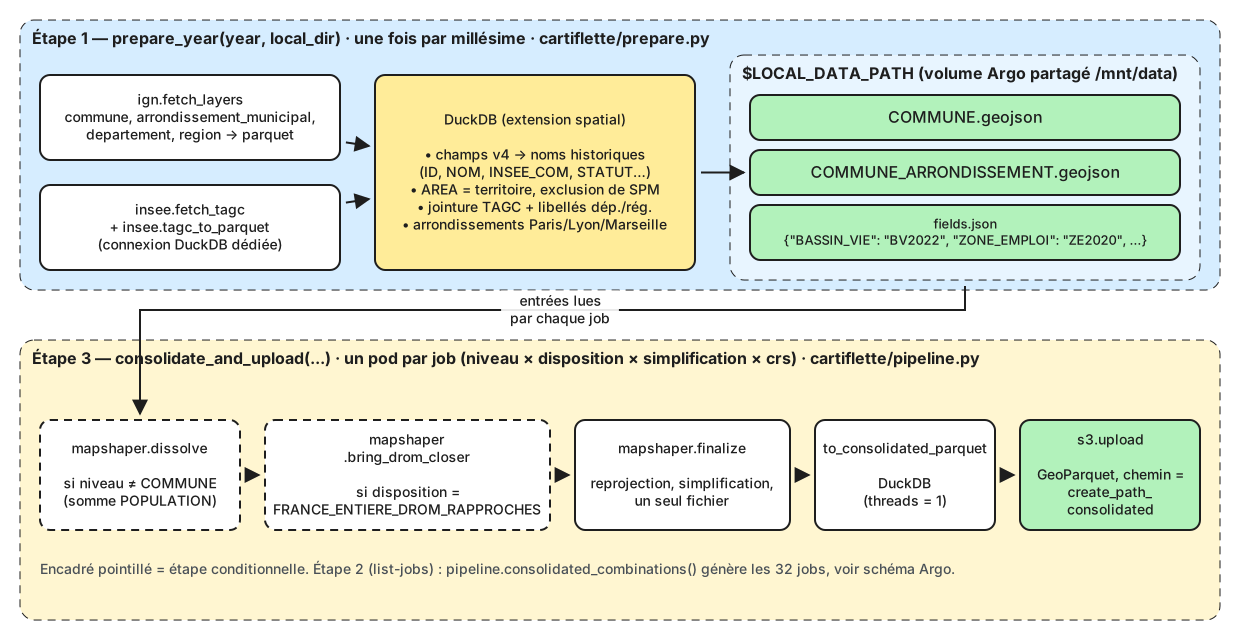
Source Excalidraw : diagrams/flux-donnees.excalidraw
Le code source de ce projet privilégie la programmation fonctionnelle plutôt que la programmation orientée object.
Cela permet de rendre le développement du projet plus simple mais reste robuste en cloisonnant les fonctions à un objectif unique.
| Module | Rôle | Fonctions principales |
|---|---|---|
config.py |
emplacements de lecture et d’écriture, libellés historiques, dispositions (LAYOUTS) et taille des groupes de lignes du GeoParquet |
constantes WRITE_BUCKET, WRITE_PATH, ALLOW_PRODUCTION_WRITE, LAYOUTS, ROW_GROUP_SIZE |
http.py |
session HTTP avec relances (429, 5xx), téléchargement vérifié par Content-Length |
get_session, download_file |
ign.py |
lecture du catalogue Atom de la Géoplateforme, choix de l’édition, téléchargement des couches en GeoParquet (ou GPKG converti) | list_editions, select_edition, list_files, fetch_layers, gpkg_to_parquet |
insee.py |
téléchargement de la TAGC et conversion xlsx → parquet | fetch_tagc, tagc_to_parquet |
prepare.py |
étape 1 : requêtes DuckDB qui produisent les entrées communes à tous les jobs | prepare_year, communes_query, enrich_query, zoning_fields |
mapshaper.py |
appels à mapshaper (liste d’arguments, jamais shell=True) |
dissolve, bring_drom_closer, finalize |
pipeline.py |
étapes 2 et 3 : liste des jobs, traitement d’un job GeoParquet, envoi | consolidated_combinations, process_consolidated, to_consolidated_parquet, consolidate_and_upload |
paths.py |
contrat de chemins (voir plus haut) | create_path_consolidated |
s3.py |
seul point d’écriture S3, avec le garde-fou production | get_fs, check_write_target, upload |
argo-pipeline/src/ contient de petits scripts en ligne de commande, un par étape Argo, qui ne font qu’appeler ces fonctions : check_target.py, prepare.py, crossproduct.py, consolidate.py.
Étape 1 — prepare_year
- Source IGN : ADMIN EXPRESS COG CARTO édition 4-0, « France entière » (zone
FRA), WGS84. Catalogue Atom :https://data.geopf.fr/chunk/telechargement/resource/ADMIN-EXPRESS-COG-CARTO. GeoParquet à partir de 2026, GPKG (archive.7z) seulement pour 2025.select_editionpréfère le GeoParquet, puis le GPKG, puis le shapefile et, à format égal, la date la plus récente. - Éditions 3-x (2021 à 2024) : shapefile seulement (
3-1__SHP_WGS84G_FRA_2022-04-15,3-2__SHP_WGS84G_FRA_2023-05-03,3-2__SHP_WGS84G_FRA_2024-02-22), une archive.7zavec un fichier par couche (COMMUNE.shp…).ign.shapefile_to_parquetrenomme leurs champs en noms de l’édition 4-0 (ign.SHAPEFILE_LAYERS:INSEE_COM→code_insee,INSEE_ARM→code_insee…), si bien que la suite du pipeline ne distingue pas les éditions. Saint-Pierre-et-Miquelon n’y figure pas. - Limite de débit : la Géoplateforme accepte 1 requête par seconde.
http.get_sessionrelance automatiquement sur les erreurs 429. - Noms de champs : l’édition 4-0 a renommé tous les champs (
code_insee,population…).communes_queryles ramène aux noms historiques (ID,NOM,INSEE_COM,STATUT,POPULATION) et ajouteAREA(nom du territoire), pour que les attributs publiés ne changent pas. - Territoires : métropole et les 5 DROM. Saint-Pierre-et-Miquelon (
code_insee_du_departement = 'NR') est exclu. - TAGC Insee :
table-appartenance-geo-communes-{year}.zip, en-tête en ligne 6. Elle apporteINSEE_DEP,INSEE_REG,EPCIet les zonages d’études (ZE2020,UU2020,AAV2020,BV2022…). Le millésime de ces zonages change dans le nom du champ (BV2012est devenuBV2022).zoning_fieldsle détecte donc à l’exécution et l’écrit dansfields.json, sans rien coder en dur. - Sorties :
COMMUNE.geojson,COMMUNE_ARRONDISSEMENT.geojson(Paris, Lyon et Marseille remplacées par leurs arrondissements municipaux,INSEE_COG= code de l’arrondissement) etfields.json.
Étape 2 — consolidated_combinations
Produit des 8 niveaux de polygones du dictionnaire FILTERS (niveau des polygones → niveaux par lesquels son GeoParquet peut être filtré), des 2 dispositions (config.LAYOUTS), de SIMPLIFICATIONS = [0, 50] et de CRS = [4326], soit 32 jobs : 8 niveaux × 2 dispositions × 2 simplifications × 1 projection.
Étape 3 — consolidate_and_upload (un job)
check_write_target: échoue avant tout traitement si la cible est la production non autorisée ;process_consolidated: repart deCOMMUNE.geojson(ouCOMMUNE_ARRONDISSEMENT.geojson), puis :mapshaper.dissolvesi le niveau n’est pas la commune (somme des populations), en gardant les champs de tous les niveaux de filtre possibles (filter_levels) ;mapshaper.bring_drom_closerpour la dispositionFRANCE_ENTIERE_DROM_RAPPROCHES(DROM déplacés et agrandis près de la métropole, zoom sur l’Île-de-France) ;mapshaper.finalize: reprojection et simplification, en un seul GeoJSON intermédiaire ;
to_consolidated_parquet: conversion par DuckDB (tri, groupes de lignes,bbox, métadonnéesgeoen version 1.1.0 etcartiflette:filter_columns) ;uploadau chemin donné parcreate_path_consolidated.
La simplification est calculée sur tout le territoire du niveau : le résultat diffère légèrement des anciens GeoJSON découpés par valeur, ce qui est accepté.
Les champs qui portent le code de chaque niveau sont dans mapshaper.LEVEL_FIELDS, complétés par fields.json pour les zonages.
Pièges DuckDB 1.5.5
Ces contournements sont déjà en place. Ils ne doivent pas être « simplifiés » :
ST_Read(GDAL) avec plusieurs threads corrompt la mémoire de façon aléatoire (segfault, Unsupported geometry type in WKB). Toujours l’appeler avecSET threads = 1, dans sa propre connexion (ign.gpkg_to_parquet,pipeline.to_consolidated_parquet).- Pour écrire un GeoParquet 1.1 (avec covering),
to_consolidated_parquetréécrit la métadonnéegeoavecGEOPARQUET_VERSION NONE. Garder le CRS en PROJJSON : geopandas ignore une simple chaîneOGC:CRS84. - Ne pas charger l’extension
exceldans une connexion qui fait du spatial. La TAGC est convertie dans une connexion séparée (insee.tagc_to_parquet). - Exécuter
LOAD spatialavantSET geometry_always_xy = true, pour que les coordonnées restent en (lon, lat). SET enable_progress_bar = false, sinon les logs Argo sont illisibles.
Infrastructure autour du code
| Élément | Fichier | Rôle |
|---|---|---|
| Image Docker | Dockerfile, docker/install-mapshaper.sh |
base python:3.12-slim, mapshaper 0.6.59, dépendances du pipeline aux versions de uv.lock, extensions DuckDB préinstallées ; pas de code (Argo clone la révision demandée) |
| Workflow Argo | argo-pipeline/pipeline.yaml |
DAG prepare → list-jobs → consolidate (voir 02) |
| CI tests | .github/workflows/check.yml |
pytest pipeline (avec mapshaper), client et API, à chaque push |
| CI lint | .github/workflows/lint.yml |
ruff (check et format --check) sur tout le dépôt : pipeline, client et API ; version figée dans le workflow |
| CI image | .github/workflows/docker.yml |
construit inseefrlab/cartiflette:v<version> sur main et sur les tags v* |
| CI PyPI | .github/workflows/pypi.yml |
publie le client sur un tag v* |