Vérifier et faire évoluer
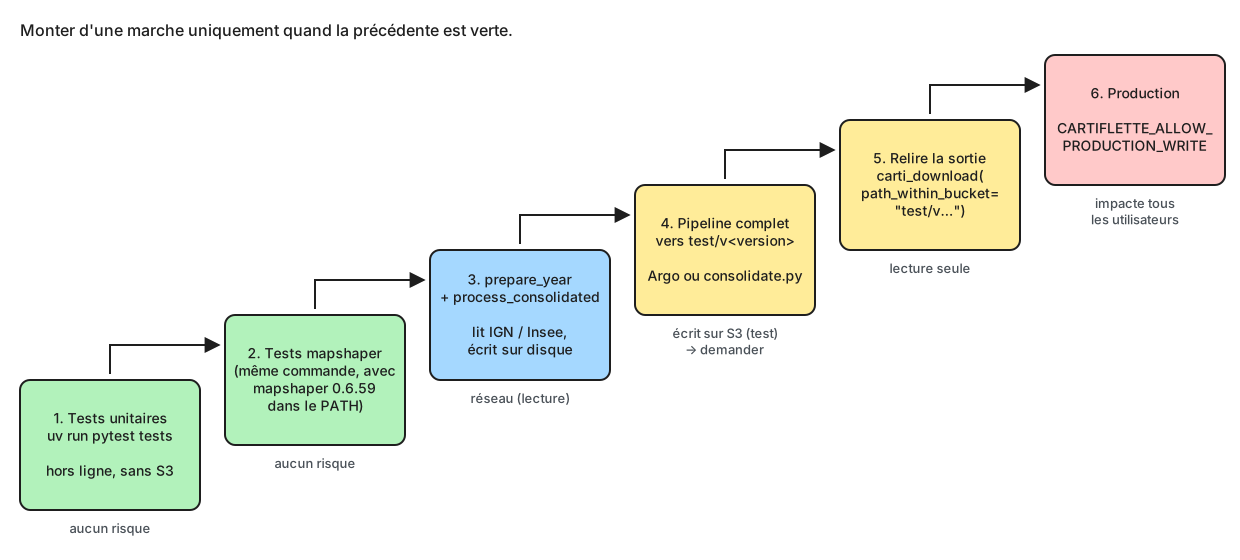
Source Excalidraw : diagrams/niveaux-verification.excalidraw
On monte les marches dans l’ordre. Les marches 1 à 3 n’écrivent rien sur S3 et suffisent à valider la plupart des changements. La marche 4 écrit dans l’espace de test : elle se décide explicitement. La marche 6 est la publication.
1–2. Tests automatiques
# Pipeline : hors ligne, jamais d'écriture S3.
# Les tests mapshaper sont ignorés (« skipped ») si mapshaper n'est pas dans le PATH.
uv run pytest tests

# Client : les tests marqués `network` lisent un fichier publié en production (lecture seule)
cd python-package/cartiflette
uv run pytest tests                  # tout
uv run pytest tests -m "not network" # hors ligne

# Qualité du code (à la racine)
uvx ruff check .
uvx vulture cartiflette argo-pipeline/src --min-confidence 80
La CI (check.yml) installe mapshaper 0.6.59 et lance les deux suites à chaque push. Les tests d’intégration, eux, se lancent à la main après une écriture en test (ils lisent test/v0.3.0 pour 2022 à 2026, et la production pour 2022 en GeoJSON) :
cd python-package/cartiflette
uv run pytest -m integration
CARTIFLETTE_TEST_PATH=production CARTIFLETTE_TEST_YEARS=2023,2024,2025,2026 uv run pytest -m integration
Un skipped en local n’est donc pas un passed : installer mapshaper (voir 02, prérequis) avant de conclure.
Ce que couvrent les tests
| Brique | Fichier de test | Ce qui est vérifié | Besoin |
|---|---|---|---|
ign |
tests/test_ign.py |
analyse des noms d’édition, préférence GeoParquet > GPKG, année absente, pagination Atom (réponses HTTP simulées) | — |
prepare |
tests/test_prepare.py |
requêtes DuckDB sur de petites tables qui imitent l’IGN 4-0 et la TAGC : renommage des champs, exclusion de SPM, arrondissements PLM, jointure TAGC, écriture GeoJSON, détection des zonages | — |
pipeline |
tests/test_pipeline.py |
nombre de jobs (32), refus de la production avant traitement, process_consolidated sur 4 communes synthétiques (métadonnées geo 1.1.0 et cartiflette:filter_columns, bbox, tri, zonage à cheval sur deux territoires) |
mapshaper pour test_process_consolidated et test_dissolve_* |
argo |
tests/test_argo.py |
garde-fous du workflow (cible de test par défaut, version de l’image, ressources, logs), liste des jobs, absence d’étape GeoJSON | — |
paths, s3 |
tests/test_paths_and_s3.py |
chaîne de chemin exacte du GeoParquet (contrat), cible par défaut ≠ production, refus de la production, upload sans toucher S3 (système de fichiers simulé) |
— |
| client | python-package/.../tests/test_client.py |
mêmes chaînes de chemin, formats, concaténation GeoJSON, repli REGION=01 → 1, lecture filtrée d’un GeoParquet consolidé (stockage local simulé), erreurs (filtre impossible, valeur absente, année sans GeoParquet), lecture d’un fichier de production |
réseau pour network |
| intégration | python-package/.../tests/test_integration.py |
cas d’usage du site cartiflette sur les fichiers publiés : communes avec arrondissements de la petite couronne (dissolve, jointure spatiale, INSEE_COG), Lyon et Marseille, départements DROM rapprochés (jointure sur INSEE_DEP, POPULATION), cartes France entière des niveaux de la page d’accueil (avec ou sans DROM rapprochés, simplification 0 et 50, emprises), communes de départements, métadonnées, moteur DuckDB |
réseau ; lancé seulement avec -m integration |
Ce que les tests ne couvrent pas : le vrai schéma des sources IGN et Insee de l’année, le volume réel des données et le workflow Argo. Ces points se vérifient à la marche 3.
3. Vérifier une brique à la main, en local
Toutes les commandes ci-dessous lisent les sources publiques et écrivent uniquement sur le disque. On suppose :
YEAR=2026
DATA=/tmp/cartiflette/$YEAR
Catalogue IGN : l’édition existe-t-elle ?
uv run python -c "
from cartiflette import ign
from cartiflette.http import get_session
s = get_session()
edition = ign.select_edition(ign.list_editions(s), $YEAR)
print(edition)
print(*ign.list_files(edition, s), sep='\n')
"
On attend ADMIN-EXPRESS-COG-CARTO_4-0__GEOPARQUET_WGS84G_FRA_$YEAR-01-01 (ou GPKG pour 2025, 3-x__SHP_WGS84G_FRA_… pour 2021 à 2024), et en GeoParquet un fichier par couche (commune.parquet, arrondissement_municipal.parquet, departement.parquet, region.parquet…).
TAGC Insee : le fichier est-il publié ?
curl -sI -o /dev/null -w "%{http_code}\n" \
  "https://www.insee.fr/fr/statistiques/fichier/7671844/table-appartenance-geo-communes-$YEAR.zip"
200 attendu. Un 404 veut dire que le fichier n’est pas encore publié, ou qu’il a été rangé sous un autre identifiant de page : dans ce cas, mettre à jour insee.TAGC_URL.
Préparation : schéma des sources et sorties de prepare_year
uv run python argo-pipeline/src/prepare.py --year $YEAR --localpath $DATASi la préparation échoue sur un champ inconnu, comparer le schéma reçu avec les champs attendus par prepare.communes_query et prepare.communes_arrondissement_query :
uv run python -c "
import duckdb
for layer in ['commune', 'arrondissement_municipal', 'departement', 'region']:
    cols = [c[0] for c in duckdb.sql(f\"DESCRIBE '$DATA/raw/{layer}.parquet'\").fetchall()]
    print(layer, cols)
print('tagc', [c[0] for c in duckdb.sql(\"DESCRIBE '$DATA/raw/tagc.parquet'\").fetchall()])
"
cat $DATA/fields.json
Champs IGN utilisés : cleabs, nom_officiel, code_insee, statut, population, code_insee_du_departement, code_insee_de_la_commune_de_rattach, geometrie. Champs TAGC utilisés : CODGEO, LIBGEO, DEP, REG, et les zonages BVxxxx, ZExxxx, UUxxxx, AAVxxxx.
Puis contrôler le contenu. Toujours ouvrir le GeoJSON avec threads = 1 (voir pièges DuckDB) :
uv run python -c "
import duckdb
con = duckdb.connect()
con.execute('SET threads = 1; SET enable_progress_bar = false; INSTALL spatial; LOAD spatial;')
con.sql('''
    SELECT AREA, count(*) AS communes, sum(POPULATION) AS population,
           count(*) FILTER (WHERE INSEE_DEP IS NULL) AS sans_tagc
    FROM ST_Read('$DATA/COMMUNE.geojson') GROUP BY 1 ORDER BY 1
''').show()
"
Points à contrôler :
- 6 territoires (
guadeloupe,guyane,martinique,mayotte,metropole,reunion), et pas de Saint-Pierre-et-Miquelon ; - environ 34 900 communes au total, un ordre de grandeur proche de l’année précédente ;
sans_tagc = 0. Sinon, des codes communes de l’IGN ne sont pas dans la TAGC (millésimes décalés) et ces communes n’auront ni département ni région ;- population totale plausible (environ 68 millions).
Traitements mapshaper : un job, sans S3
uv run python -c "
import duckdb
from cartiflette.pipeline import process_consolidated
p = process_consolidated('$DATA', '/tmp/cartiflette/work', 'DEPARTEMENT', 'FRANCE_ENTIERE', 50, 4326)
print(duckdb.sql(f\"SELECT INSEE_REG, count(*) FROM '{p}' GROUP BY 1 ORDER BY 1\"))
"
mapshaper /tmp/cartiflette/work/final.geojson -info
process_consolidated ne vide pas le dossier de travail : le supprimer entre deux essais (rm -rf /tmp/cartiflette/work). Il contient aussi le GeoJSON intermédiaire final.geojson, utile pour le contrôle visuel.
Résultats attendus pour quelques combinaisons utiles :
| Niveau × disposition | À regarder dans le GeoParquet |
|---|---|
DEPARTEMENT × FRANCE_ENTIERE |
101 lignes ; 8 départements pour INSEE_REG = '11' |
REGION × FRANCE_ENTIERE |
18 lignes, dont 13 avec AREA = 'metropole' |
COMMUNE × FRANCE_ENTIERE_DROM_RAPPROCHES |
à afficher : DROM près de la métropole, zoom de l’Île-de-France par département |
BASSIN_VIE × FRANCE_ENTIERE |
le champ BVxxxx vient bien de fields.json |
COMMUNE_ARRONDISSEMENT × FRANCE_ENTIERE |
20 arrondissements pour INSEE_DEP = '75' |
Pour FRANCE_ENTIERE_DROM_RAPPROCHES, seul un contrôle visuel est fiable : ouvrir final.geojson sur https://mapshaper.org ou dans QGIS.
Conversion GeoParquet
uv run python -c "
import json, pyarrow.parquet as pq
from cartiflette.pipeline import process_consolidated
p = process_consolidated('/tmp/cartiflette', '/tmp/cartiflette/work_parquet', 'DEPARTEMENT', 'FRANCE_ENTIERE', 50, 4326)
f = pq.ParquetFile(p)
print(f.metadata.num_rows, 'lignes,', f.metadata.num_row_groups, 'groupes de lignes')
print(f.schema_arrow.names)
print(f.schema_arrow.metadata[b'cartiflette:filter_columns'])
print(json.loads(f.schema_arrow.metadata[b'geo'])['version'])
"
On attend 101 lignes, une colonne geometry (et pas geom ni OGC_FID), une colonne bbox, les champs historiques, SOURCE, la version 1.1.0 et les filtres REGION, TERRITOIRE, FRANCE_ENTIERE.
4–5. Relire une sortie publiée en test
Après une exécution qui a écrit dans test/v<version> (Argo ou consolidate.py, voir 02), la relire avec le client, comme le ferait un utilisateur :
from cartiflette import carti_download

gdf = carti_download(
    values=["11"],
    borders="DEPARTEMENT",
    filter_by="REGION",
    year=2026,
    simplification=50,
    vectorfile_format="parquet",
    path_within_bucket="test/v0.3.0",   # au lieu de "production"
)
gdf.plot()
Si le préfixe de test n’est pas lisible publiquement (erreur HTTP 403), lister et lire les fichiers avec s3fs, en lecture seule, avec vos identifiants :
from cartiflette.s3 import get_fs

fs = get_fs()
fs.ls("projet-cartiflette/test/v0.3.0/provider=IGN/dataset_family=ADMINEXPRESS/"
      "source=EXPRESS-COG-CARTO-TERRITOIRE/year=2026")
Comparer avec le millésime précédent publié en production, pour détecter une rupture pour les utilisateurs :
kw = dict(values=["11"], borders="DEPARTEMENT", filter_by="REGION", simplification=50)
old = carti_download(year=2025, **kw)
new = carti_download(year=2026, path_within_bucket="test/v0.3.0", **kw)
print(set(old.columns) ^ set(new.columns))   # colonnes ajoutées ou disparues
print(len(old), len(new))
Côté contrat, on doit retrouver les mêmes noms de colonnes, les mêmes valeurs de découpage (REGION=11, DEPARTEMENT=75…) et les deux formats pour chaque fichier.
Faire évoluer le pipeline : marches à suivre
Pour chaque changement : travailler sur une branche, puis monter les marches 1 → 3 (et 4–5 si la sortie change).
Ajouter un nouveau millésime
Le cas le plus fréquent, en général sans modifier de code.
- Vérifier l’édition IGN et la TAGC (marche 3, les deux premières sections).
prepare_yearen local, puis contrôle des sorties (communes sans TAGC, territoires, population).- Trois ou quatre jobs
process, dont unFRANCE_ENTIERE_DROM_RAPPROCHEScontrôlé visuellement. - Argo vers
test/v<version>avec-p years='["YYYY"]', puis relecture et comparaison avec l’année précédente. - Décider la mise en production (02, C).
Si l’IGN change de version de produit (5-0…) ou renomme des champs, adapter ign._EDITION et les requêtes de prepare.py, en ajoutant les nouveaux cas dans tests/test_ign.py et tests/test_prepare.py. Les noms de champs publiés doivent rester ceux d’aujourd’hui.
Ajouter un niveau de polygones ou de découpage
Exemple : ajouter les EPCI.
pipeline.FILTERS: déclarer le niveau et les niveaux par lesquels il peut être filtré.- Champ de code :
- s’il est stable, dans
mapshaper.LEVEL_FIELDS(ex."EPCI": "EPCI") ; - s’il porte un millésime (comme
BV2022), dansprepare.ZONING_PREFIXES.
- s’il est stable, dans
- Si le niveau est découpé en
FRANCE_ENTIERE_DROM_RAPPROCHES: ajouter une entrée dansmapshaper.IDF_ZOOM, sinonbring_drom_closerlève unKeyError. - Libellé éventuel dans
mapshaper.LABEL_FIELDS. - Tests : mettre à jour le nombre de jobs dans
test_consolidated_combinations(32 aujourd’hui) et ajouter un cas àtest_process_consolidated. - Client : compléter la docstring de
carti_download(liste desbordersetfilter_by). - Marche 3 sur le nouveau niveau, dont un contrôle visuel.
Ajouter un format de sortie
Le pipeline ne publie que du GeoParquet (consolidate_and_upload, un fichier par niveau et disposition). Les autres formats se servent à la demande à partir de lui : c’est le rôle de l’API (api/), qui produit le GeoJSON. Avant d’ajouter une étape au pipeline, se demander si l’API ne peut pas plutôt le servir : c’est ce qui a permis de supprimer les 74 jobs GeoJSON par millésime.
S’il faut vraiment un nouveau fichier publié :
- Le produire dans
consolidate_and_uploadou une nouvelle étape, avec sa fonction de chemin danspaths.pyet son pendant côté client. - Client :
utils.FORMATS, et la lecture dansclient.py. - Argo : une liste de jobs et un fan-out si c’est une nouvelle étape.
- Tests des deux côtés (
test_standardize_format, un test de production côté pipeline).
Changer une simplification ou une projection
pipeline.SIMPLIFICATIONS et pipeline.CRS. Le nombre de jobs change (mettre à jour test_consolidated_combinations) et le volume de fichiers sur S3 aussi.
Monter la version de mapshaper ou de DuckDB
À éviter sans raison forte. Les deux versions sont fixées à plusieurs endroits (docker/install-mapshaper.sh, .github/workflows/check.yml, pyproject.toml) et les contournements DuckDB sont propres à la 1.5.5. Si on les monte : garder tous les contournements, relancer toute la marche 3 avec comparaison des sorties avant/après, puis construire une nouvelle image (nouvelle version du pipeline).
Modifier le contrat de chemins
Ne pas le faire : les clients R et JS, hors de ce dépôt, cesseraient de trouver les fichiers. Si c’est vraiment nécessaire, modifier cartiflette/paths.py et python-package/cartiflette/cartiflette/utils.py ensemble, avec les tests des deux côtés, et coordonner avec les autres clients.