Étape II : Manipuler les données
Une fois les données chargées (étape I), on peut les transformer de deux façons avec DuckDB :
- avec les verbes
dplyrque vous utilisez déjà (dplyr::filter(),dplyr::group_by(),dplyr::summarise(), …) ; - en écrivant directement du SQL natif.
Dans les deux cas, c’est le même moteur DuckDB qui exécute le calcul. dplyr ne fait que traduire votre code en SQL en coulisses. Le résultat est identique, le choix est une question de confort et de complexité de la requête.
Dans les exemples ci-dessous, on part d’une table ma_table chargée à l’étape précédente (une table ou une vue DuckDB), avec des colonnes region, annee et valeur.
Avec dplyr
Il faut le package dbplyr, qui fait le lien entre dplyr et une base de données (c’est le même mécanisme qu’avec n’importe quelle base compatible DBI).
install.packages(c("dplyr", "dbplyr"))

library(dplyr)
On utilise dplyr::tbl() pour créer un lien paresseux (lazy) vers la table : rien n’est encore chargé en mémoire. C’est la dernière étape dplyr::collect() qui s’occupera de le faire.
ma_table_tbl <- dplyr::tbl(con, "ma_table")

resultat <- ma_table_tbl |>
  dplyr::filter(annee == 2024) |>
  dplyr::group_by(region) |>
  dplyr::summarise(valeur_moyenne = mean(valeur, na.rm = TRUE)) |>
  dplyr::collect()
Les verbes dplyr sont traduits en SQL et exécutés par DuckDB uniquement au moment du dplyr::collect(), c’est seulement à ce moment que le résultat est rapatrié dans R sous forme de data.frame.
Pour voir à quoi ressemble le SQL généré, utilisez dplyr::show_query() à la place de dplyr::collect() :
ma_table_tbl |>
  dplyr::filter(annee == 2024) |>
  dplyr::group_by(region) |>
  dplyr::summarise(valeur_moyenne = mean(valeur, na.rm = TRUE)) |>
  dplyr::show_query()
Travailler à partir d’un résultat intermédiaire avec compute()
Dans certains cas, la sauvegarde de traitements, coûteux à calculer, dans une table intermédiaire peut être bénéfique pour l’analyse : cette table peut servir de point de départ à plusieurs analyses différentes.
L’instruction dplyr::compute() exécute la requête et sauvegarde le résultat comme une table intermédiaire dans la base DuckDB (une table temporaire), sans le sortir de la base. Il renvoie un nouveau lien paresseux (tbl_lazy) vers cette table, pas un data.frame.
Sans compute(), chaque nouvelle opération relance tout le calcul depuis le début; avec compute(), le calcul lourd n’est fait qu’une fois, et chaque étape suivante repart directement de la table mise en cache dans DuckDB, y compris via plusieurs collect() successifs, sur des sous-parties différentes du résultat.
Quant à l’instruction dplyr::collect(), elle rapatrie le résultat dans R, sous forme de data.frame. C’est la seule des deux commandes qui charge des données en mémoire R.
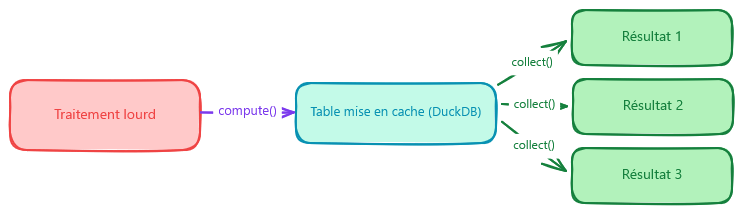
compute() sauvegarde le résultat dans une table DuckDB ; collect() peut ensuite être appelé plusieurs fois dessus, sans jamais relancer le traitement lourd# Le traitement lourd n'est exécuté qu'une seule fois, ici, avec compute()
etape_intermediaire <- ma_table_tbl |>
dplyr::filter(annee == 2024) |>
dplyr::group_by(region) |>
dplyr::summarise(valeur_moyenne = mean(valeur, na.rm = TRUE)) |>
dplyr::compute()
# On repart ensuite plusieurs fois de cette table mise en cache,
# sans jamais refaire le calcul lourd
resultat_1 <- etape_intermediaire |> dplyr::filter(valeur_moyenne > 15) |> dplyr::collect()
resultat_2 <- etape_intermediaire |> dplyr::arrange(dplyr::desc(valeur_moyenne)) |> dplyr::collect()
resultat_3 <- etape_intermediaire |> dplyr::collect()Pour un usage novice, un seul dplyr::collect() à la toute fin de la chaîne suffit largement. dplyr::compute() devient utile dès qu’un même calcul lourd est réutilisé plusieurs fois dans un script, pour plusieurs collect(), ou plusieurs sous-analyses différentes.
Avec le SQL natif
On peut écrire la même requête directement en SQL, avec DBI::dbGetQuery() :
resultat <- DBI::dbGetQuery(con, "
  SELECT region, AVG(valeur) AS valeur_moyenne
  FROM ma_table
  WHERE annee = 2024
  GROUP BY region
")
Le résultat est directement un data.frame, pas besoin de dplyr::collect().
Quand utiliser l’un ou l’autre ?
| dplyr | SQL natif | |
|---|---|---|
| Prise en main | Immédiate si vous connaissez déjà dplyr |
Nécessite de connaître le SQL |
| Requêtes simples (filtrer, grouper, agréger) | Très lisible | Très lisible aussi |
| Requêtes complexes (fenêtres, sous-requêtes, CTE) | Peut devenir difficile à écrire | Plus naturel et plus proche du moteur |
Intégration dans un pipeline dplyr existant |
Directe | Nécessite de repasser par DBI::dbGetQuery() |
Il n’y a pas de mauvais choix : vous pouvez même mélanger les deux dans un même script, selon la requête à écrire. DuckDB exécute les deux de la même façon.
Sources
- Intégration dbplyr dans le client R : duckdb.org/docs/current/clients/r
- Documentation de
compute()(dbplyr) : dbplyr.tidyverse.org/reference/compute.tbl_sql - Introduction au SQL DuckDB : duckdb.org/docs/current/sql/introduction