Associer des arrondissements à des données communales avec cartiflette
Ce tutoriel vise à illustrer deux cas d’usage classiques de cartiflette : récupérer un fonds de carte mélangeant les niveaux administratifs différents que sont communes et arrondissements, et le restreindre à un zonage d’étude de l’Insee (zone d’emploi, unité urbaine, aire d’attraction des villes, bassin de vie), que les fonds de carte de l’IGN ne fournissent pas.
Ce besoin classique est illustré à travers la construction d’une carte de la disponibilité de vélibs dans la zone d’emploi de Paris : Paris intra-muros, la petite couronne et quelques communes limitrophes, comme Argenteuil, qui ont aussi des stations. L’objectif de ce tutoriel est de faire une carte du nombre de vélibs au km² dans chaque arrondissement de Paris intra-muros et chaque commune de la zone d’emploi. Il illustre, pas à pas, la manière dont cartiflette simplifie la création de la Figure 1 :
AstucePourquoi utiliser cartiflette pour ce type de besoins ?
- Beaucoup moins de ligne de code à écrire :
- Réduit le temps nécessaire avant d’obtenir une carte exploratoire, ce qui permet de se concentrer sur la construction de celle-ci plutôt que les étapes antérieures
- Réduit la difficulté à mettre à jour le code ;
- Moins de bande passante et d’espace disque utilisé car seule la donnée nécessaire est téléchargée : les quelques communes demandées, pas la France entière ;
- Des zonages d’étude prêts à l’emploi : les zones d’emploi, unités urbaines, aires d’attraction des villes et bassins de vie de l’Insee servent directement de filtre, sans avoir à télécharger ni à croiser la table d’appartenance géographique des communes ;
- Moindre besoin d’expertise en SIG car la librairie fournit un
GeoDataFrameprêt à l’emploi ce qui ne nécessite pas une connaissance pointue dans le domaine (système de projection, format shapefile, etc.) ; - Moins de risque d’erreur que lorsqu’on fait soi-même la combinaison de sources à des niveaux administratifs différents (accoler le masque des arrondissements à celui des communes limitrophes nécessite beaucoup de précautions) ;
- Bénéficier de métadonnées supplémentaires sur les communes que les fonds de carte
AdminExpress
NoteEt Lyon et Marseille ?
cartiflette fournit le même découpage par arrondissement pour les villes de Lyon et Marseille. Pour cela, il suffit de demander une zone géographique englobant Lyon et Marseille, par exemple le département du Rhône ou la région Provence Alpes Côte d’Azur.
Mise en gardePour en apprendre plus sur le traitement de données géographiques avec Python
Ce tutoriel présuppose une connaissance minimale de l’écosystème Python pour le traitement de données spatiales. Pour se familiariser à celui-ci, vous pouvez consulter ce cours d’Introduction à Python pour la data science de l’ENSAE ParisTech.
1 Préliminaire: récupération des localisations des stations
Les données Vélib que nous utiliserons sont récupérables directement avec GeoPandas. Il s’agit de la capacité et la localisation des stations sous la forme de latitude-longitude1
import geopandas as gpd

velib_data = "https://opendata.paris.fr/explore/dataset/velib-emplacement-des-stations/download/?format=geojson&timezone=Europe/Berlin&lang=fr"
stations = gpd.read_file(velib_data)
Ces données prennent la forme suivante:
| capacity | stationcode | coordonnees_geo | name | geometry | |
|---|---|---|---|---|---|
| 0 | 35 | 7002 | [48.848563233059, 2.3204218259346] | Vaneau - Sèvres | POINT (2.32042 48.84856) |
| 1 | 40 | 30002 | [48.908168131015, 2.4530601033354] | Jean Rostand - Paul Vaillant Couturier | POINT (2.45306 48.90817) |
et peuvent être localisées sur une carte de la manière suivante:
Voir le code pour générer la carte interactive 👇️
import folium
from folium.plugins import MarkerCluster
# 1. Calcul du centre de la carte et des bornes sw et ne
stations['lon'] = stations.geometry.x
stations['lat'] = stations.geometry.y
center = stations[['lat', 'lon']].mean().values.tolist()
sw = stations[['lat', 'lon']].min().values.tolist()
ne = stations[['lat', 'lon']].max().values.tolist()
m = folium.Map(location=center, tiles='OpenStreetMap')
marker_cluster = MarkerCluster().add_to(m)
# Add the markers to the MarkerCluster
for i in range(len(stations)):
folium.Marker(
location=[stations.iloc[i]['lat'], stations.iloc[i]['lon']],
popup=stations.iloc[i]['name']
).add_to(marker_cluster)
# Fit the map bounds to the markers
m.fit_bounds([sw, ne])
m- 1
- Cette fonctionnalité permet d’avoir une carte interactive avec zoom progressifs car le nombre de stations est important ce qui ralentirait la carte de toutes les afficher
Make this Notebook Trusted to load map: File -> Trust Notebook
Nous allons avoir besoin des contours d’arrondissements et de communes pour deux raisons:
- Localiser les stations à ce niveau d’analyse par le biais d’une jointure spatiale avant de pouvoir les agréger à ce niveau ;
- Représenter ces données sur une carte présentant Paris intra-muros et les villes limitrophes participant au système Vélib.
2 Récupérer les contours administratifs officiels l’IGN via cartiflette
2.1 La récupération des données utilisant cartiflette
Les contours administratifs officiels sont produits par l’IGN et utilisent le code officiel géographique (COG) (liste officielle des entités administratives) produit par l’Insee.
La source la plus simple pour répondre à notre besoin est ADMIN EXPRESS COG CARTO, ici dans son édition 2026. En l’occurrence, seuls quelques espaces nous intéressent : les villes et arrondissements desservis par Vélib. Se limiter aux départements de la petite couronne (75, 92, 93 et 94) laisserait de côté les stations d’Argenteuil, dans le Val-d’Oise. La zone d’emploi de Paris, un zonage d’étude de l’Insee, correspond mieux à l’emprise du réseau. Ce zonage n’existe pas dans ADMIN EXPRESS : cartiflette l’ajoute à chaque commune à partir de la table d’appartenance géographique des communes de l’Insee.
Avec la fonction carti_download, l’import de ces données est assez transparent:
- 1
-
On récupère seulement la zone d’emploi de Paris (code
1109), l’emprise la plus petite qui couvre tout le réseau Vélib. Les autres zonages de l’Insee s’utilisent de la même manière :filter_by="UNITE_URBAINE","AIRE_ATTRACTION_VILLES"ou"BASSIN_VIE", tout comme les niveaux administratifs (filter_by="DEPARTEMENT"etvalues=["75", "92", "93", "94"]pour la petite couronne).cartiflettene télécharge que les parties utiles du fichier publié (au format GeoParquet), pas la France entière. - 2
-
La construction du fonds de carte
departementsse fait simplement avec la méthodedissolve. Il nous sera utile pour contextualiser la carte.
contours_villes_arrt est un GeoDataFrame classique, il est donc possible d’appliquer à celui-ci les méthodes usuelles de GeoPandas par exemple la méthode dissolve ci-dessus. Le masque obtenu pour notre carte est celui-ci
contours_villes_arrt.plot()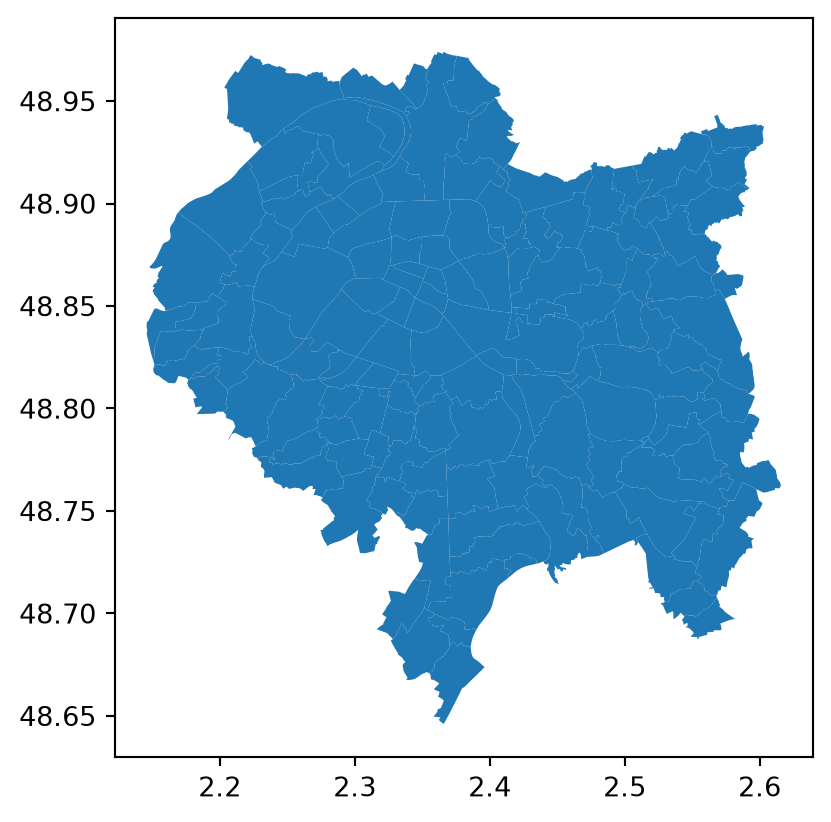
Pour voir le code permettant d’obtenir un GeoDataFrame équivalent sans passer par cartiflette, vous pouvez vous rendre dans la partie Comment faire sans cartiflette ?. La section Bilan fournit quelques éléments de comparaison entre l’approche avec et celle sans cartiflette (temps de traitement, volume de données téléchargées, nombre de lignes de codes, etc.).
2.2 Le reste du travail après avoir utilisé cartiflette
La suite du travail n’est pas intrinsèquement lié à cartiflette mais correspond à de la manipulation de données spatiales.
Comme nous avons besoin de localiser les stations dans les arrondissements, nous faisons une jointure spatiale entre notre fonds de carte et nos données Vélib
stations_info = gpd.sjoin(
    stations, contours_villes_arrt, predicate="within"
)
Outre la localisation des stations au niveau communes ou arrondissement, cela permet d’ajouter une ribambelle de métadonnées (des informations annexes) à nos données initiales:
| capacity | stationcode | coordonnees_geo | name | geometry | lon | lat | index_right | ID | NOM | ... | ZE2020 | UU2020 | AAV2020 | BV2022 | INSEE_DEP | INSEE_REG | LIBELLE_DEPARTEMENT | LIBELLE_REGION | PAYS | SOURCE | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 35 | 7002 | [48.848563233059, 2.3204218259346] | Vaneau - Sèvres | POINT (2.32042 48.84856) | 2.320422 | 48.848563 | 6 | ARR_MUN_0000000000075107 | Paris 7e Arrondissement | ... | 1109 | 00851 | 001 | 75056 | 75 | 11 | Paris | Île-de-France | France | IGN:EXPRESS-COG-CARTO-TERRITOIRE |
| 1 | 40 | 30002 | [48.908168131015, 2.4530601033354] | Jean Rostand - Paul Vaillant Couturier | POINT (2.45306 48.90817) | 2.453060 | 48.908168 | 64 | COMMUNE_0000000000093008 | Bobigny | ... | 1109 | 00851 | 001 | 75056 | 93 | 11 | Seine-Saint-Denis | Île-de-France | France | IGN:EXPRESS-COG-CARTO-TERRITOIRE |
2 rows × 30 columns
Le décompte des stations par communes et arrondissements se fait alors assez aisément en utilisant la grammaire Pandas. Pour cela, il est possible d’utiliser la variable INSEE_COG construite par cartiflette pour consolider les codes communes des arrondissements et des communes2
comptes = (
    stations_info
    .groupby("INSEE_COG")
    .agg({"capacity": "sum"})
    .reset_index()
)
Enfin, il ne reste plus qu’à construire la variable d’intérêt, ce qui n’est pas du travail lié à cartiflette:
Dérouler 👇️ pour voir le code permettant préparer la carte
import pandas as pd
# Conversion des variables
contours_villes_arrt["INSEE_COG"] = contours_villes_arrt["INSEE_COG"].astype(str)
comptes["INSEE_COG"] = comptes["INSEE_COG"].astype(str)
# Jointure pour retrouver la dimension géographique de nos données agrégées
comptes_velib_by_city_arrt = contours_villes_arrt.merge(
comptes, how = "inner", on = "INSEE_COG"
)
comptes_velib_by_city_arrt['densite'] = comptes_velib_by_city_arrt['capacity']
# Création des variables pour la taille de nos ronds proportionnels
df_points = comptes_velib_by_city_arrt.copy()
df_points["markersize"] = 12*df_points["densite"].div(comptes_velib_by_city_arrt.to_crs(2154).area.div(10**6).sum())
bins = [-float('inf'), 20, 100, 500, float('inf')]
labels = ["Moins de 20", "Entre 20 et 100", "Entre 100 et 500", "Plus de 500"]
df_points["markercolor"] = pd.cut(
df_points['densite'], bins=bins, labels=labels, right=True
)
# Centre de nos cercles
df_points["geometry"] = df_points["geometry"].centroid- 1
-
On force la conversion de la variable
INSEE_COGen string pour éviter le typeobjectdePandasqui peut poser des problèmes lors des jointures.
Finalement, on obtient la carte avec le code suivant
Dérouler 👇️ pour voir le code permettant de faire la carte
import matplotlib.pyplot as plt

# Create a figure and axes object
fig, ax = plt.subplots(figsize=(7, 7))

# Plot the base map
comptes_velib_by_city_arrt.plot(
    ax=ax,
    color="lightgray",
    edgecolor="grey",
    linewidth=0.4,
    alpha=0.3
)

# Plot the points, one class at a time, with customized colors and sizes
palette = plt.get_cmap("viridis", len(labels))
for i, label in enumerate(labels):
    classe = df_points.loc[df_points["markercolor"] == label]
    if len(classe) > 0:
        classe.plot(
            ax=ax,
            markersize=classe["markersize"],
            color=palette(i),
            alpha=0.7,
            label=label,
        )
ax.legend(
    title="Nombre de vélib par km²",
    loc="upper center",
    ncol=2,
    bbox_to_anchor=(0.5, 0.05),
)

# Plot the department boundaries
departements.boundary.plot(ax=ax, edgecolor="black", alpha=0.3)

# Remove axes and set the title
ax.axis("off")
ax.set_title("Densité de vélibs dans la zone d'emploi de Paris")

# Add source text
plt.figtext(
    0.3,
    0.15,
    "Source : IGN, ADMIN EXPRESS COG CARTO 2026 ; Insee, zonages d'étude ; cartiflette",
    wrap=True,
    horizontalalignment="center",
    fontsize=8,
    style="italic",
)

# Show the final plot
plt.show()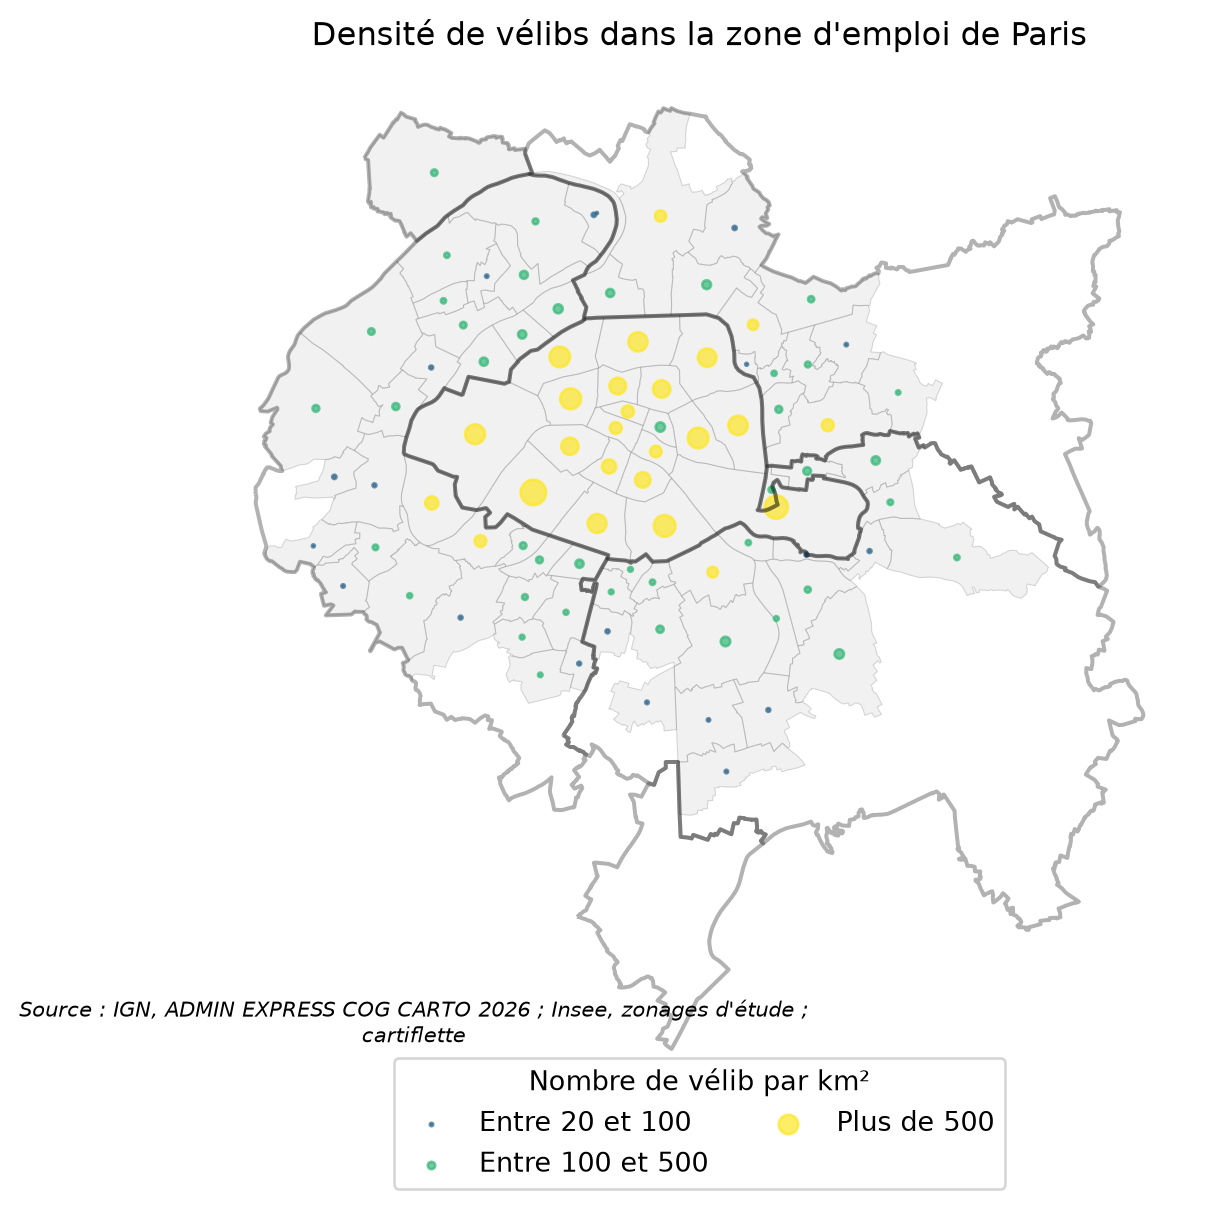
4 Bilan
Si le fait qu’il suffise que le code de cartiflette se réduise à Listing 1 contre Listing 2, Listing 3 et Listing 4 pour obtenir un résultat équivalent ne suffit pas, si le fait que le GeoDataFrame obtenu avec cartiflette comporte plus de métadonnées que celui créé sans ce package n’est pas non plus suffisant, la suite déroule quelques arguments supplémentaires de l’intérêt d’utiliser cartiflette.
4.1 Volume de données téléchargées
Fonction convert_size pour avoir les tailles de fichiers dans un format lisible
import math


def convert_size(size_bytes):
    if size_bytes == 0:
        return "0 o"
    size_name = ("o", "Ko", "Mo", "Go", "To")
    i = int(math.floor(math.log(size_bytes, 1024)))
    s = round(size_bytes / math.pow(1024, i), 1)
    return f"{s} {size_name[i]}"
Taille des couches téléchargées sur le site de l’IGN
poids_ign_bytes = sum(os.path.getsize(f) for f in fichiers_ign.values())
poids_ign = convert_size(poids_ign_bytes)
Taille des mêmes données issues de cartiflette
writedir = "cartiflette-data/usecase1"
os.makedirs(writedir, exist_ok=True)
contours_villes_arrt.to_parquet(f"{writedir}/contours.parquet")
poids_cartiflette_bytes = os.path.getsize(f"{writedir}/contours.parquet")
poids_cartiflette = convert_size(poids_cartiflette_bytes)- 1
-
On enregistre le
GeoDataFrameobtenu aveccartifletteau même format (GeoParquet) que les couches de l’IGN, pour une comparaison honnête.
La première base de comparaison possible est la quantité de données nécessaires :
- les données
cartiflettereprésenteraient 212.4 Ko si elles étaient stockées sur disque ; - sans passer par
cartiflette, il faut télécharger 116.2 Mo : les couches de la France entière et la table d’appartenance de l’Insee.
Autrement dit, les données récupérées sans cartiflette représentent 560 fois le volume de celles exclusivement nécessaires pour cette carte.
4.2 Nombre de lignes de code
En ce qui concerne le temps de développement de ce code, on est sur quelques secondes pour le code avec cartiflette en utilisant la documentation interactive d’exemples contre plusieurs dizaines de minutes pour le code sans cartiflette.
4.3 Temps de traitement
Le code cartiflette permet de récupérer les éléments contextuels nécessaires en 5.7 s. Sans cartiflette, il faut 13.9 s, soit un rapport de 1 à 2 pour cette tâche.
Notes de bas de page
Le système de coordonnées WGS84 (World Geodetic System 1984) est un système de référence géodésique utilisé pour représenter les positions géographiques sur la Terre. Ce système est utilisé par la plupart des applications GPS et des fournisseurs de tuiles vectorielles comme
OpenStreetMap.↩︎La variable
INSEE_COMcorrespond au code officiel géographique au niveau communal. La valeur est donc identique pour les 20 arrondissements parisiens.↩︎
3 Comment faire sans
cartiflette?L’approche est nettement plus fastidieuse sans
cartiflette. L’IGN publie chaque couche d’ADMIN EXPRESS pour la France entière, sans les zonages d’étude de l’Insee : il faut télécharger les couches complètes et la table d’appartenance géographique des communes, puis faire soi-même les filtres et l’assemblage. Cela passe par trois étapes principales :Python.La première étape consiste donc à télécharger les fichiers depuis les sites de mise à disposition de l’IGN et de l’Insee. Le code étant assez long, il n’est pas apparent par défaut mais il suffit de cliquer ci-dessous:
1️⃣ Code pour télécharger les couches de l’IGN
1️⃣ bis Code pour télécharger la table d’appartenance géographique de l’Insee
La deuxième étape consiste à importer les fonds de carte désirés. Le piège à cette étape est qu’il existe deux fonds de carte d’arrondissements : les arrondissements départementaux (subdivisions des départements) et les arrondissements municipaux (subdivisions des trois plus grandes villes françaises). Ce sont ces derniers qui nous intéressent, dans la couche
arrondissement_municipal(à ne pas confondre avecarrondissement).2️⃣ Importer les couches dans Python
Pandas(openpyxl) ne parvient pas à lire ce fichier.La 3e et dernière étape, la plus propice à faire des erreurs, est celle qui consiste à restreindre les données à notre aire d’intérêt et à superposer les masques du fonds des arrondissements municipaux avec celui des communes. Les noms de colonnes de l’IGN ont changé avec l’édition 2025 (
code_inseeau lieu deINSEE_COM…) : un code écrit pour une édition antérieure ne fonctionne plus tel quel, alors quecartiflettegarde les mêmes noms d’une année sur l’autre.3️⃣ Consolider pour obtenir le fonds de carte désiré
ZE2020) : il change quand l’Insee révise le zonage.INSEE_COGpour avoir des identifiants de localisation équivalents à ceux decartiflette